

Python爬虫:爬取小说并存储到数据库
admin
2023-05-23 22:43:09
0次
爬取小说网站的小说,并保存到数据库
第一步:先获取小说内容
#!/usr/bin/python
# -*- coding: UTF-8 -*-
import urllib2,re
domain = 'http://www.quanshu.net'
headers = {
"User-Agent": "Mozilla/5.0 (Windows NT 6.3; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.36"
}
def getTypeList(pn=1): #获取分类列表的函数
req = urllib2.Request('http://www.quanshu.net/map/%s.html' % pn) #实例将要请求的对象
req.headers = headers #替换所有头信息
#req.add_header() #添加单个头信息
res = urllib2.urlopen(req) #开始请求
html = res.read().decode('gbk') #decode解码,解码成Unicode
reg = r'(.*?)'
reg = re.compile(reg) #增加匹配效率 正则匹配返回的类型为List
return re.findall(reg,html)
def getNovelList(url): #获取章节列表函数
req = urllib2.Request(domain + url)
req.headers = headers
res = urllib2.urlopen(req)
html = res.read().decode('gbk')
reg = r'(.*?) style6\(\)'
return re.findall(reg,html)[0]
if __name__ == '__main__':
for type in range(1,10):
for url,title in getTypeList(type):
for zurl,ztitle in getNovelList(url):
print u'正则爬取----%s' %ztitle
content = getNovelContent(url.replace('index.html',zurl))
print content
break
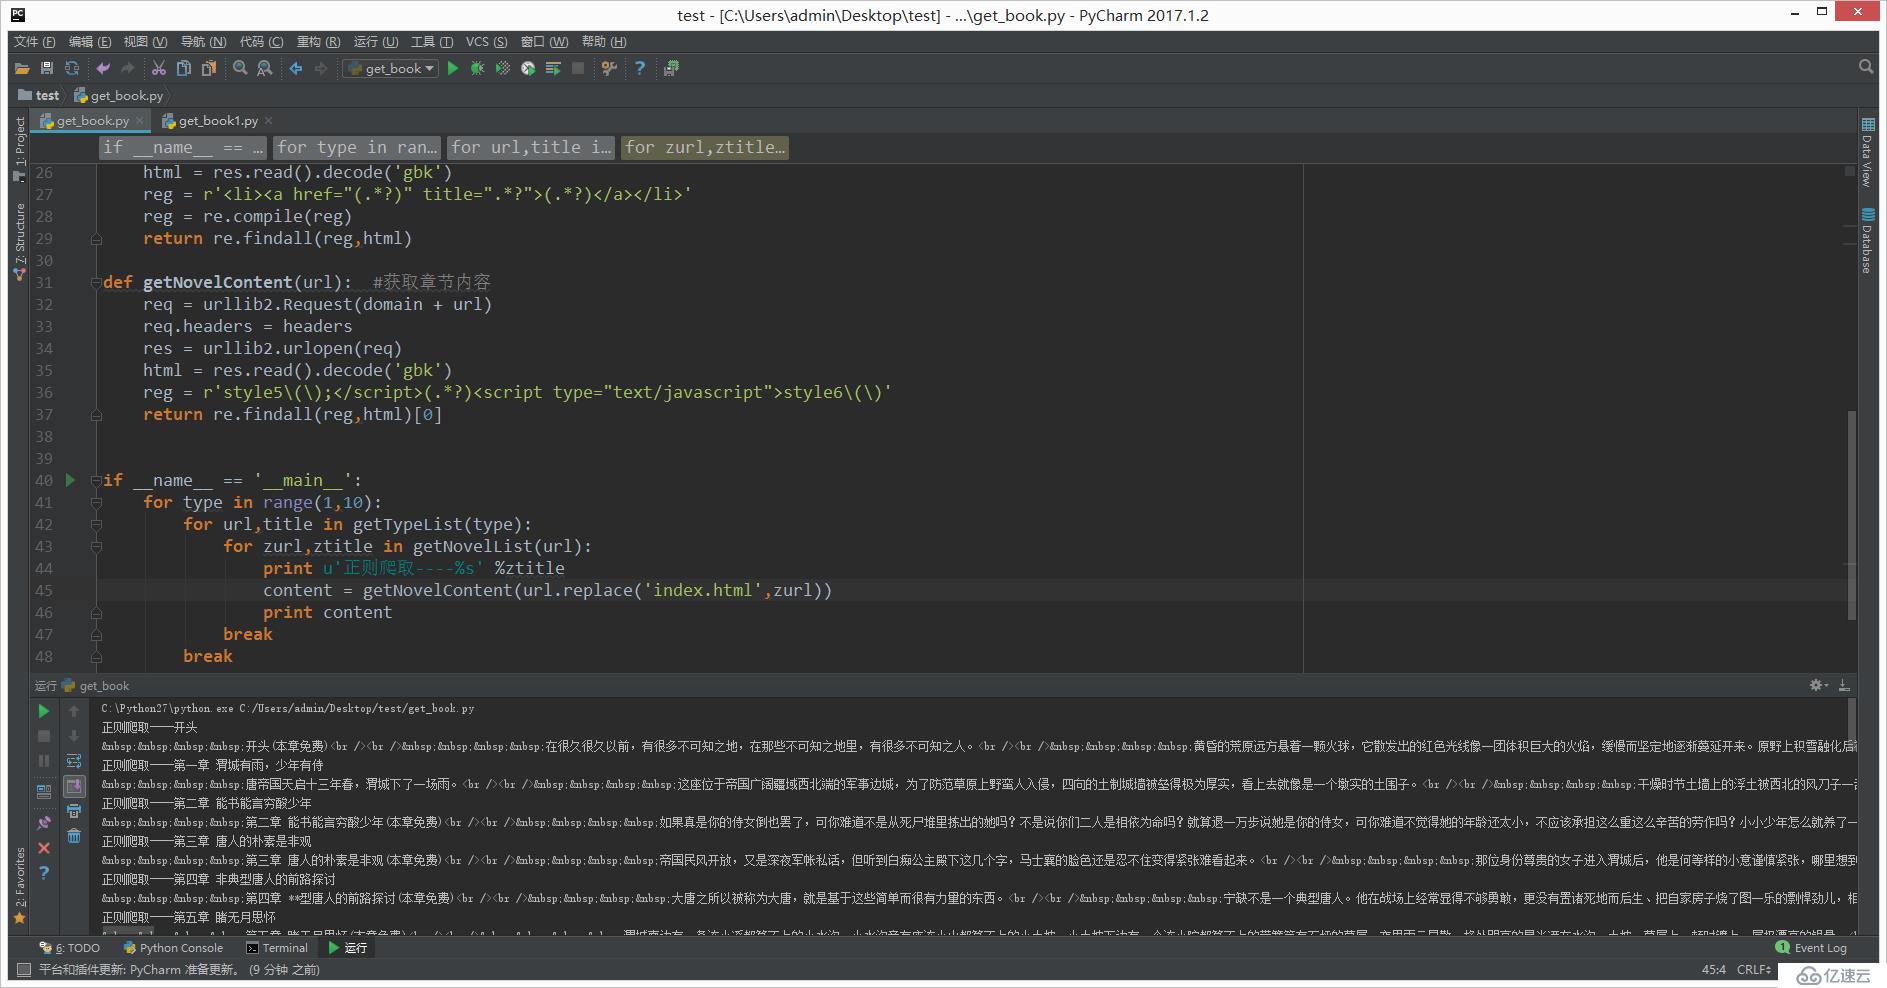
break 执行后结果如下:
第二步:存储到数据库
1、设计数据库
1.1 新建库:novel
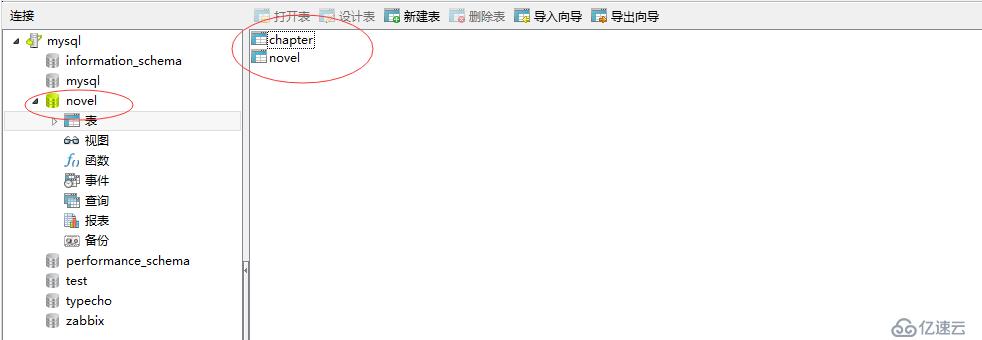
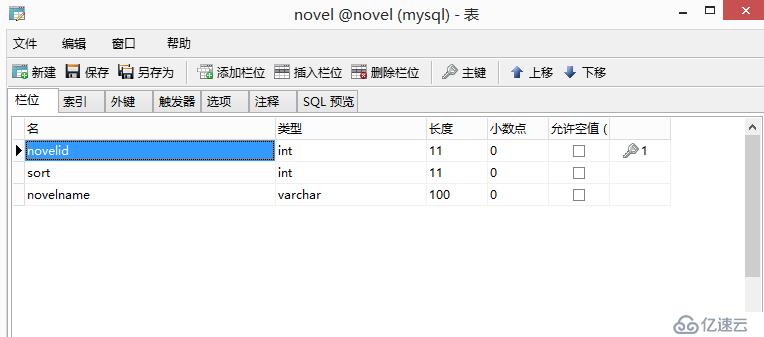
1.2 设计表:novel
1.3 设计表:chapter
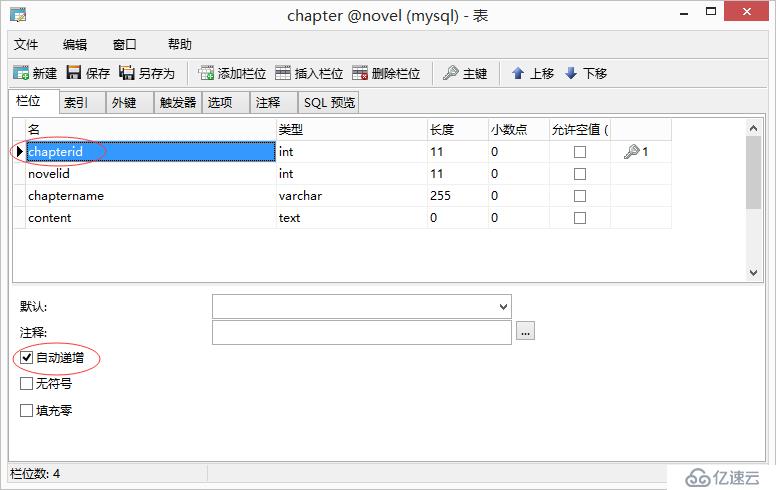
并设置外键
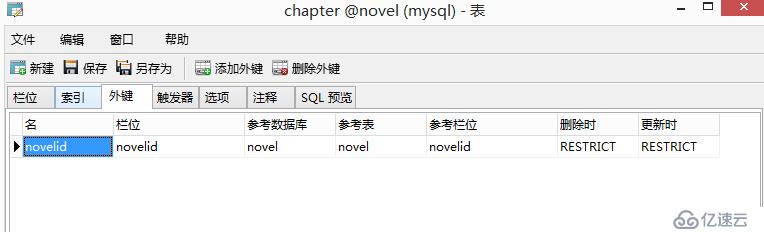
2、编写脚本
#!/usr/bin/python
# -*- coding: UTF-8 -*-
import urllib2,re
import MySQLdb
class Sql(object):
conn = MySQLdb.connect(host='192.168.19.213',port=3306,user='root',passwd='Admin123',db='novel',charset='utf8')
def addnovels(self,sort,novelname):
cur = self.conn.cursor()
cur.execute("insert into novel(sort,novelname) values(%s , '%s')" %(sort,novelname))
lastrowid = cur.lastrowid
cur.close()
self.conn.commit()
return lastrowid
def addchapters(self,novelid,chaptername,content):
cur = self.conn.cursor()
cur.execute("insert into chapter(novelid,chaptername,content) values(%s , '%s' ,'%s')" %(novelid,chaptername,content))
cur.close()
self.conn.commit()
domain = 'http://www.quanshu.net'
headers = {
"User-Agent": "Mozilla/5.0 (Windows NT 6.3; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.36"
}
def getTypeList(pn=1): #获取分类列表的函数
req = urllib2.Request('http://www.quanshu.net/map/%s.html' % pn) #实例将要请求的对象
req.headers = headers #替换所有头信息
#req.add_header() #添加单个头信息
res = urllib2.urlopen(req) #开始请求
html = res.read().decode('gbk') #decode解码,解码成Unicode
reg = r'(.*?)'
reg = re.compile(reg) #增加匹配效率 正则匹配返回的类型为List
return re.findall(reg,html)
def getNovelList(url): #获取章节列表函数
req = urllib2.Request(domain + url)
req.headers = headers
res = urllib2.urlopen(req)
html = res.read().decode('gbk')
reg = r'(.*?) style6\(\)'
return re.findall(reg,html)[0]
mysql = Sql()
if __name__ == '__main__':
for sort in range(1,10):
for url,title in getTypeList(sort):
lastrowid = mysql.addnovels(sort, title)
for zurl,ztitle in getNovelList(url):
print u'正则爬取----%s' %ztitle
content = getNovelContent(url.replace('index.html',zurl))
print u'正在存储----%s' %ztitle
mysql.addchapters(lastrowid,ztitle,content) 3、执行脚本
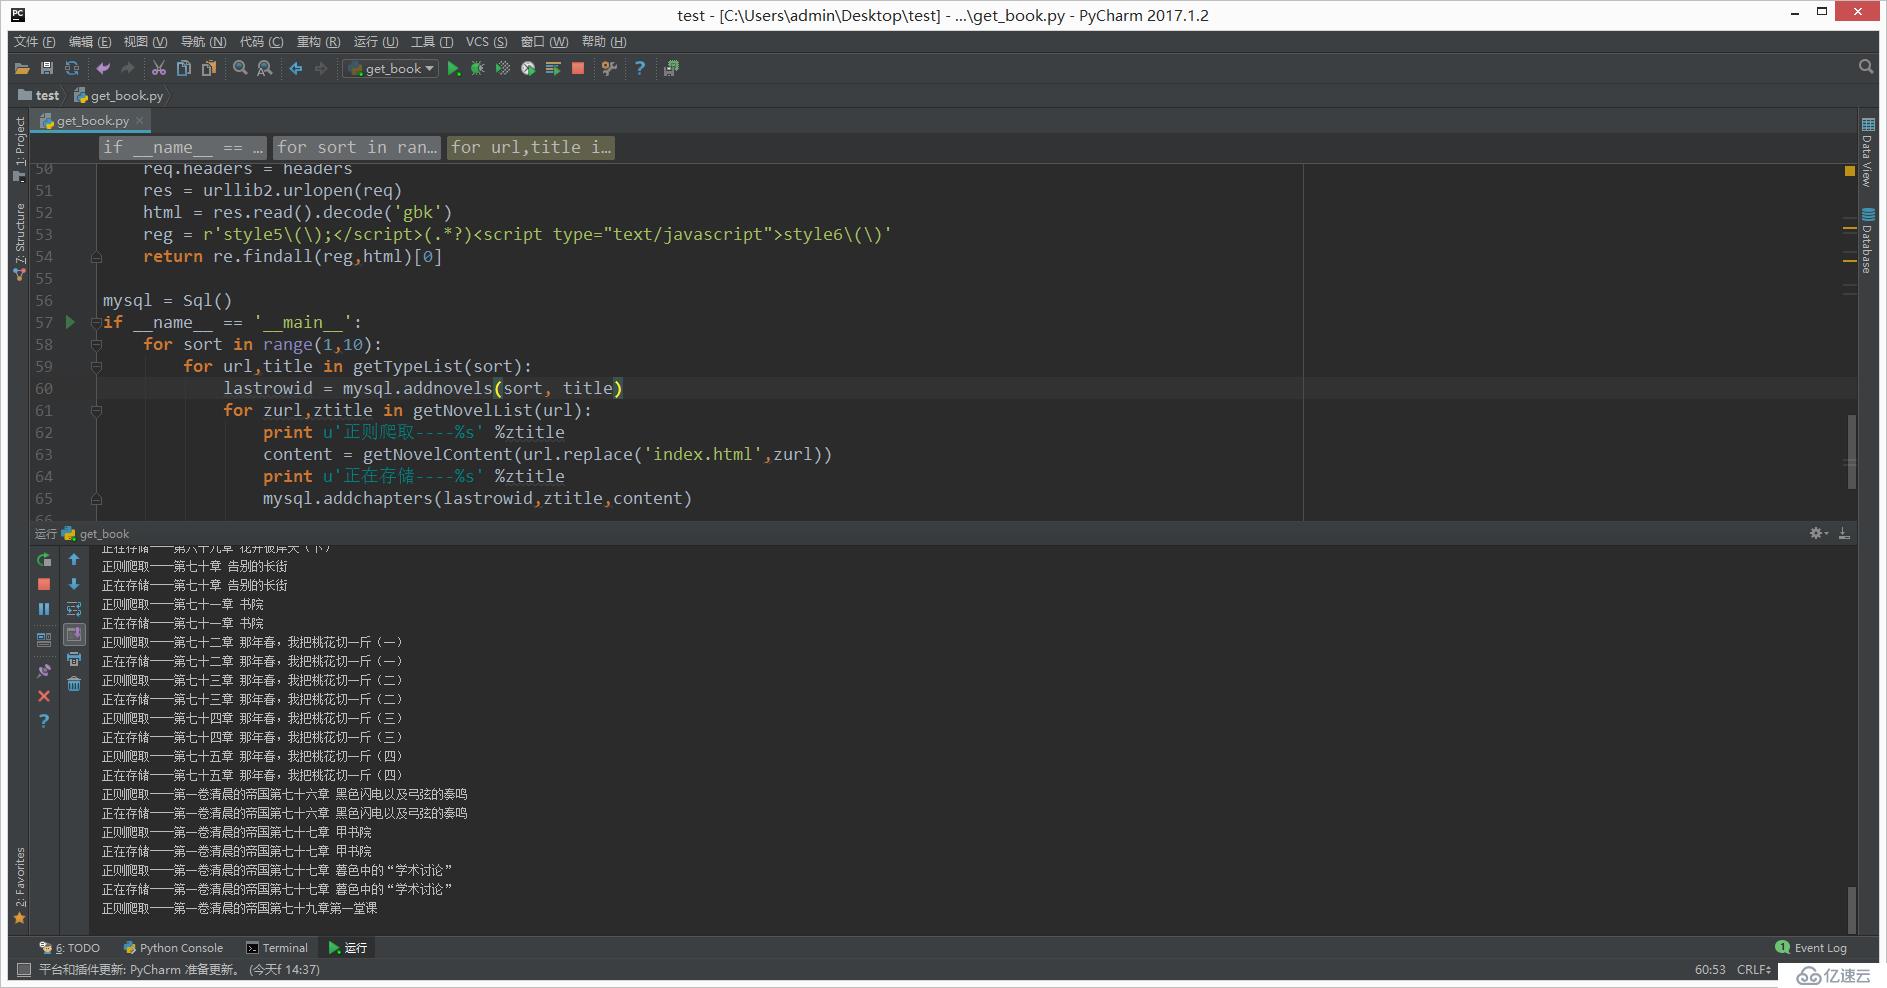
4、查看数据库
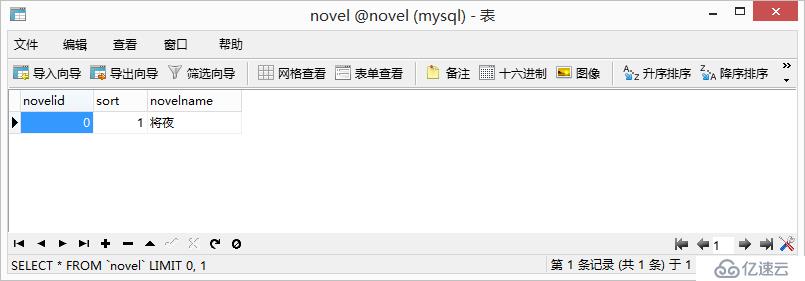
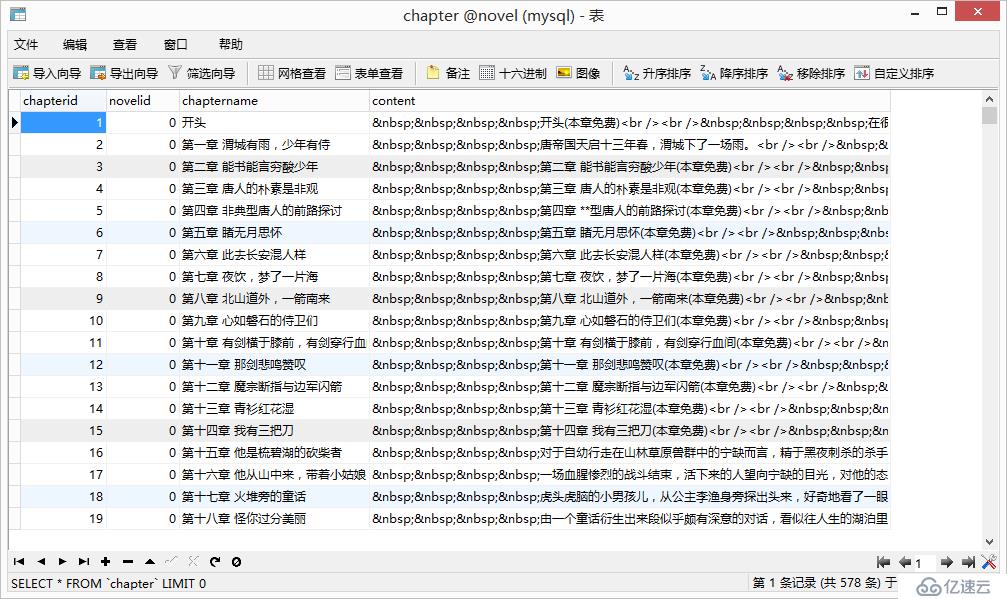
可以看到已经存储成功了。
报错:
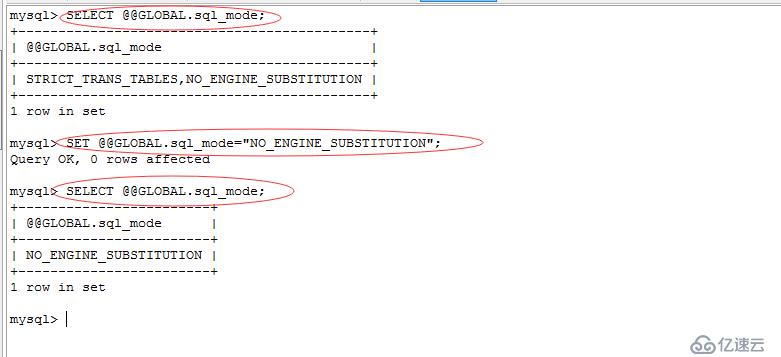
_mysql_exceptions.OperationalError: (1364, "Field 'novelid' doesn't have a default value")
解决:执行sql语句
SELECT @@GLOBAL.sql_mode;
SET @@GLOBAL.sql_mode="NO_ENGINE_SUBSTITUTION";
报错参考:http://blog.sina.com.cn/s/blog_6d2b3e4901011j9w.html
上一篇:Oracle进阶学习之创建数据库
相关内容
热门资讯
空调连续工作多久需要停机休息
空调连续工作的时间取决于多个因素,包括空调的型号、功率、使用环境和维护情况等。一般来说,空调可以连续...
空调哪个符号是除湿的
空调除湿功能通常用一个水滴形状的符号表示。不同品牌和型号的空调遥控器可能会有所差异,但一般来说,除湿...
格力空调多长时间加一次氟利昂
1、一般情况下,空调对氟利昂的使用量是非常小的,所以在空调使用了四年左右的时候再考虑加也没问题。2、...
空调用多长时间需要加氟一次
一般情况下是五年。当出现以下这几种情况时,空调才需要加氟。1、空调的室内机和室外机各有两个接口,当接...
格调生活·C标思享荟:卡萨帝在...
9月12日的郑州龙湖金融岛,夜风轻拂,灯光璀璨。“C标时刻共传奇——卡萨帝思享荟暨20周年品牌盛典郑...
品牌价值破千亿、高端份额持续领...
9月12日,“C标时刻共传奇——卡萨帝思享荟暨20周年品牌盛典郑州站”在郑州龙湖金融岛举办。2026...
空调主板坏了修800还是换新的
空调主板坏了是修还是换新,需要考虑多个因素,以下是一些建议:1. 维修成本:如果维修费用较低,比如 ...
空调开多久需要休息多长时间
问题:空调开多久需要休息多长时间回答:1、在使用空调的过程中,一般空调开7~8个小时左右需要休息2~...
中央空调多长时间清洗一次
1、一般空调开机前清洗一次即可,空调开机中间时段再清洗一次,空调关机时清洗一次,这样比较合理。2、空...
中央空调氟利昂多久加一次
看空调制热和制冷程度,很多人的观点认为氟利昂必须一年放一次,其实这个观点是错误的,理解上面有点偏差,...