

如何使用python爬虫+正向代理实现链家数据收集
admin
2023-06-28 07:23:52
0次
一、选择目标网站:
链[lian]家[jia]:https://bj.lianjia.com/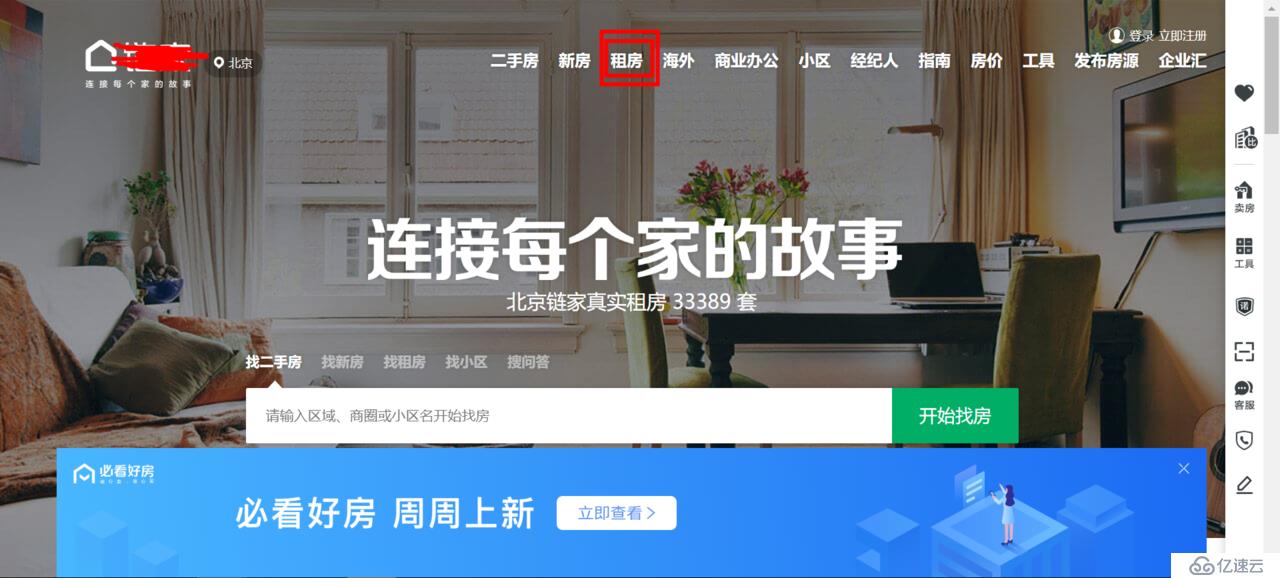
点击【租房】,进入租房首页: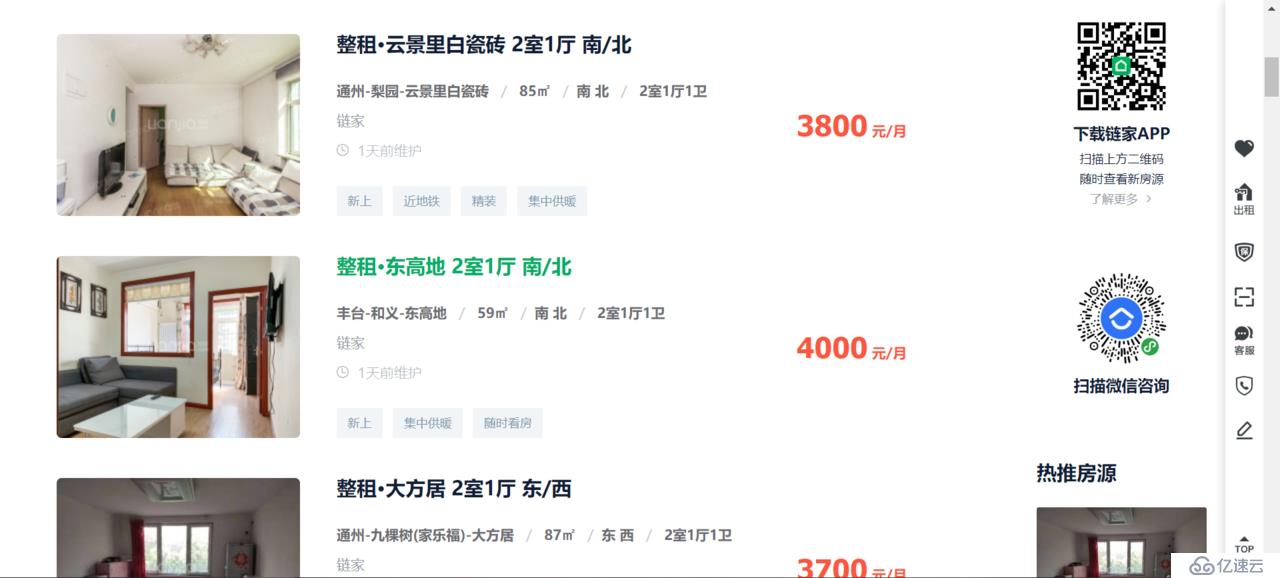
这就是要爬取的首页了;
二、先爬取一页
1、分析页面
右击一个房源的链接,点击[检查],如图: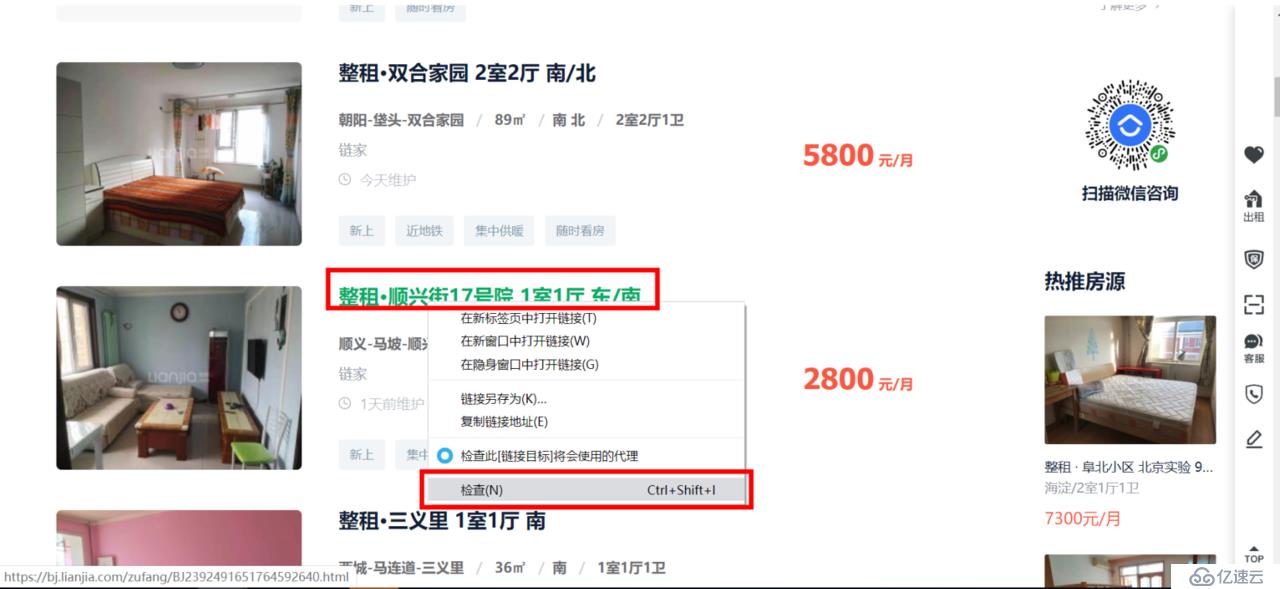
进入开发者模式,
此时可以看到 a 标签中的链接: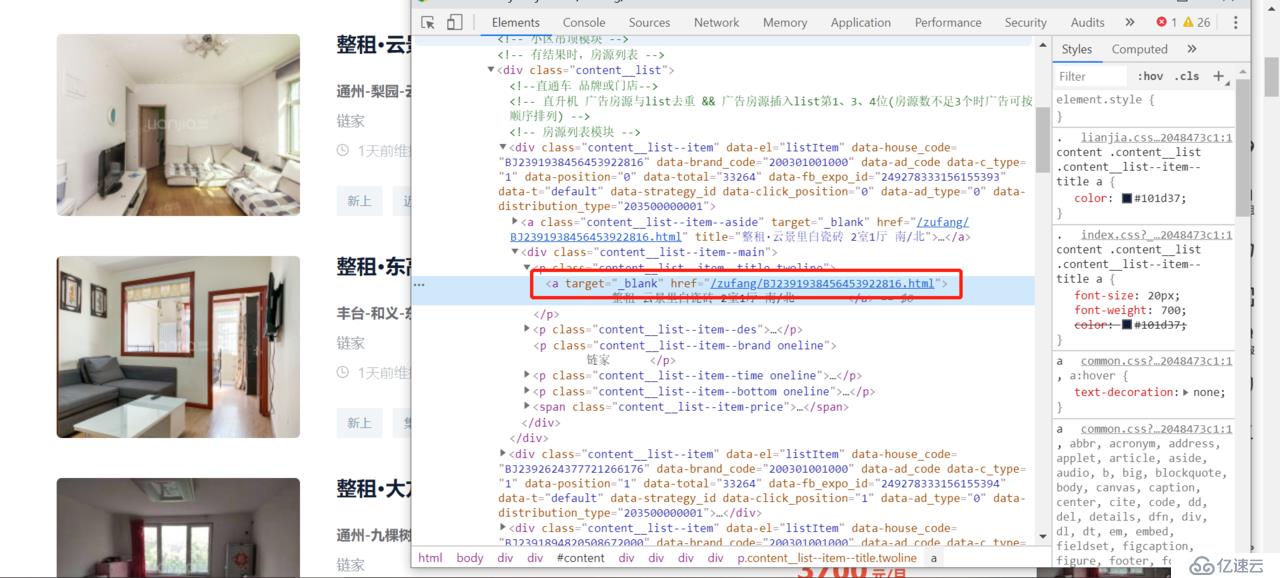
使用 xpath 就可以把链接提取出来,不过该链接是真实 url 的后半段,需要进行字符串拼接才能获取到真正的 url;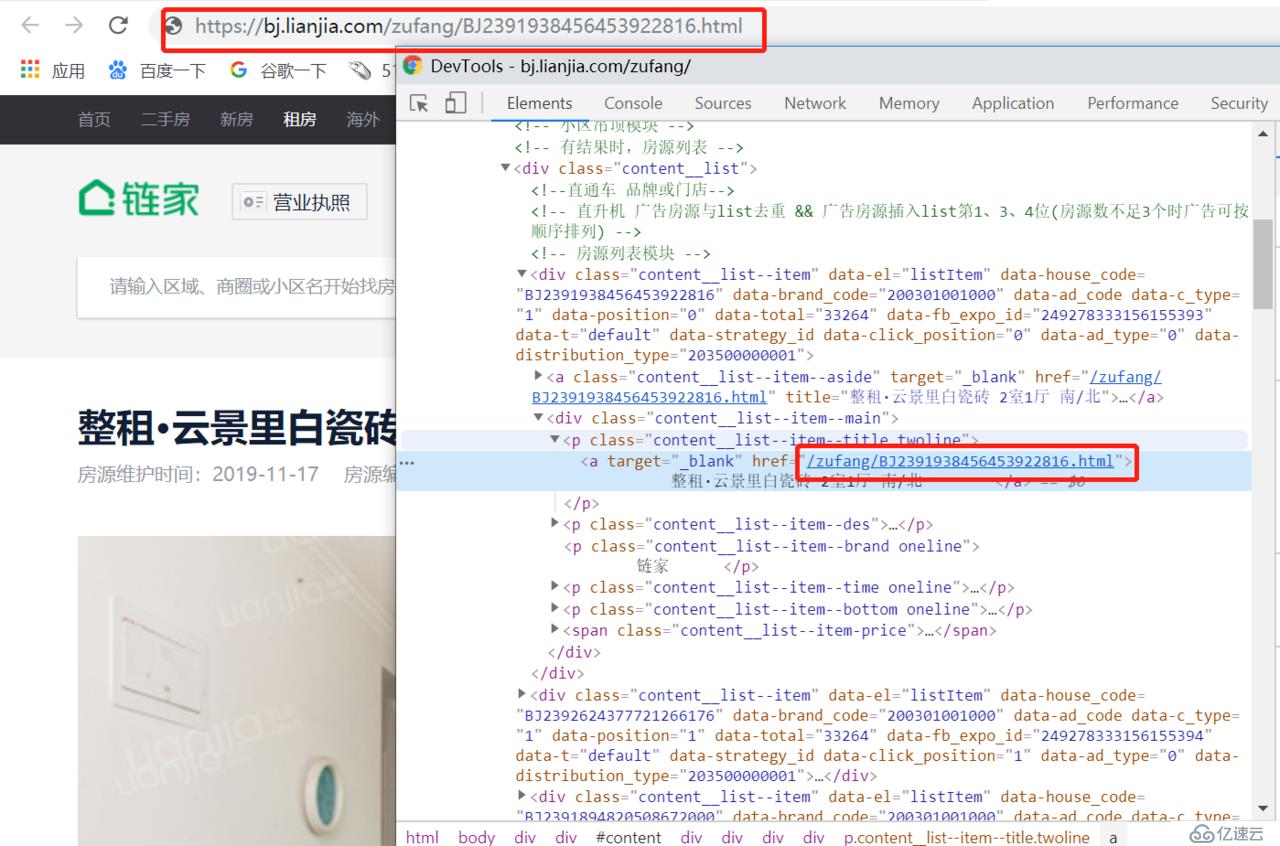
后面会在代码中体现;
爬取的信息暂且只对下图中标出的进行爬取: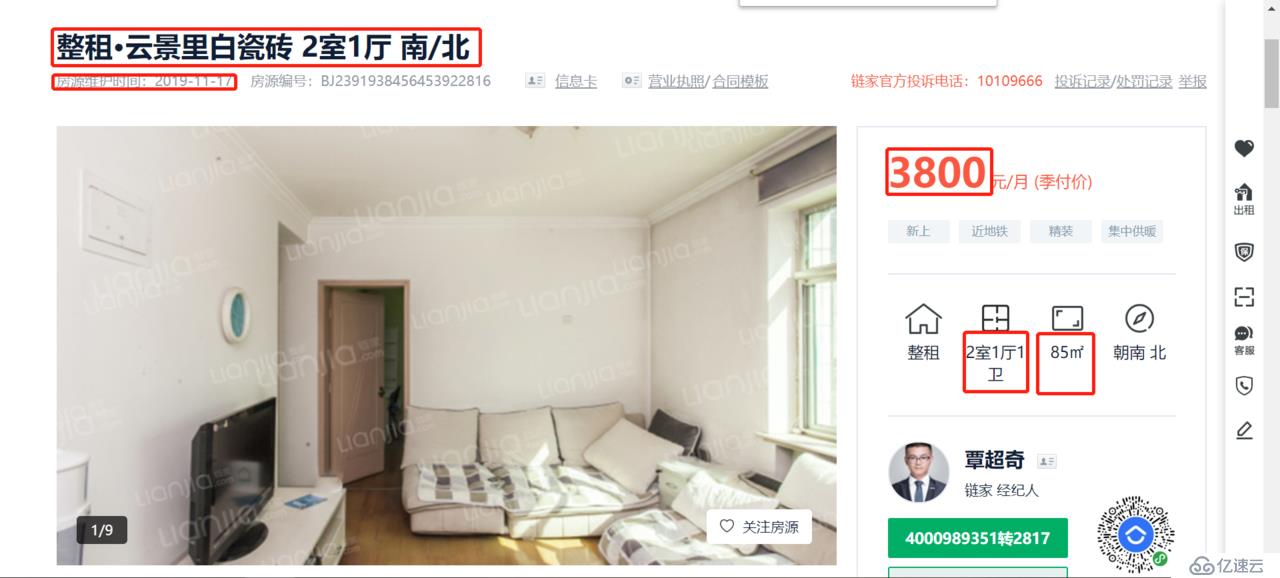
包括 标题、时间、价格、房间格局、面积 ;
三、对全部页面进行爬取
1、分析页面 url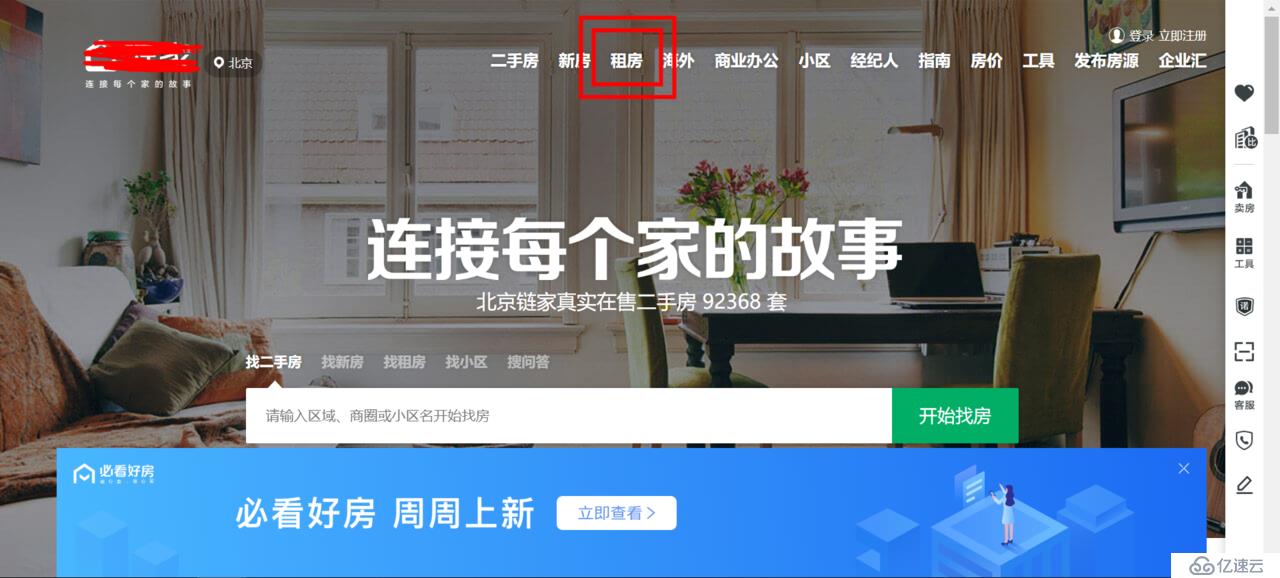
点击租房,找到其跳转到的网页:https://bj.lianjia.com/zufang/
对,这就是要爬取的首页: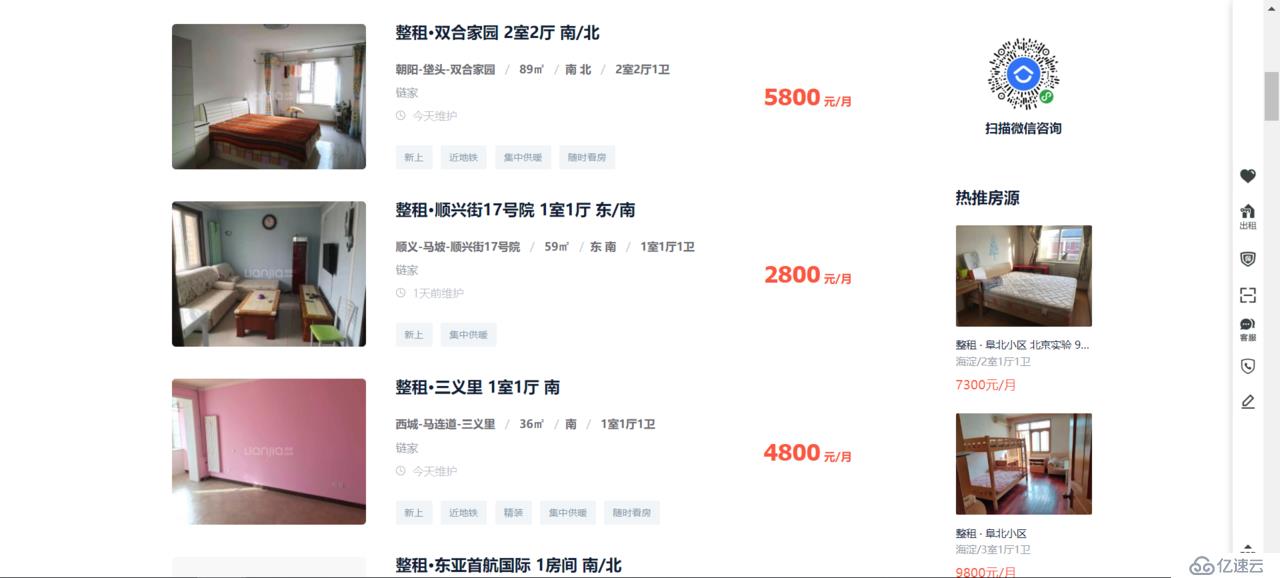
我们往下拉到最底端,点击下一页或者其他页,
第 1 页:https://bj.lianjia.com/zufang/pg1/#contentList
第 2 也:https://bj.lianjia.com/zufang/pg2/#contentList
第 3 页:https://bj.lianjia.com/zufang/pg3/#contentList
.
.
.
第 100 页:https://bj.lianjia.com/zufang/pg100/#contentList
通过观察 url 可以发现规律:每一页只有 pg 后面的数字在变,且与页数相同;
拼接字符串后使用一个循环即可对所有页面进行爬取;
四、源码
开发工具:pycharm
python版本:3.7.2
import requests
from lxml import etree

#编写了一个常用的方法,输入url即可返回text的文本;
def get_one_page(url):
    headers = {
        'User-Agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/75.0.3770.142 Safari/537.36',
    }
    response = requests.get(url,headers=headers)
    response.encoding = 'utf-8'
    if response.status_code == 200:
        return response.text
    else:
        print("请求状态码 != 200,url错误.")
        return None

for number in range(0,101):     #利用range函数循环0-100,抓去第1页到100页。
    initialize_url = "https://bj.lianjia.com/zufang/pg" + str(number) + "/#contentList"     #字符串拼接出第1页到100页的url;

    html_result = get_one_page(initialize_url)  #获取URL的text文本
    html_xpath = etree.HTML(html_result)        #转换成xpath格式
    #抓去首页中的url(每页有30条房源信息)
    page_url = html_xpath.xpath("//div[@class='content w1150']/div[@class='content__article']//div[@class='content__list']/div/a[@class='content__list--item--aside']/@href")

    for i in page_url:      #循环每一条房源url
        true_url = "https://bj.lianjia.com" + i     #获取房源的详情页面url
        true_html = get_one_page(true_url)      #获取text文本
        true_xpath = etree.HTML(true_html)      #转换成xpath格式

        #抓取页面题目,即:房源详情页的标题
        title = true_xpath.xpath("//div[@class='content clear w1150']/p[@class='content__title']//text()")
        #抓取发布时间并对字符串进行分割处理
        release_date = true_xpath.xpath("//div[@class='content clear w1150']//div[@class='content__subtitle']//text()")
        release_date_result = str(release_date[2]).strip().split(":")[1]
        #抓取价格
        price = true_xpath.xpath("//div[@class='content clear w1150']//p[@class='content__aside--title']/span//text()")
        #抓取房间样式
        house_type = true_xpath.xpath("//div[@class='content clear w1150']//ul[@class='content__aside__list']//span[2]//text()")
        #抓取房间面积
        acreage = true_xpath.xpath("//div[@class='content clear w1150']//ul[@class='content__aside__list']//span[3]//text()")

        print(str(title) + " --- " + str(release_date_result) + " --- " + str(price) + " --- " + str(house_type) + " --- " + str(acreage))

        #写入操作,将信息写入一个text文本中
        with open(r"E:\admin.txt",'a') as f:
            f.write(str(title) + " --- " + str(release_date_result) + " --- " + str(price) + " --- " + str(house_type) + " --- " + str(acreage) + "\n")
最后将爬取的信息一边输出一边写入文本;当然也可以直接写入 JSON 文件或者直接存入数据库;
相关内容
热门资讯
空调连续工作多久需要停机休息
空调连续工作的时间取决于多个因素,包括空调的型号、功率、使用环境和维护情况等。一般来说,空调可以连续...
空调哪个符号是除湿的
空调除湿功能通常用一个水滴形状的符号表示。不同品牌和型号的空调遥控器可能会有所差异,但一般来说,除湿...
格力空调多长时间加一次氟利昂
1、一般情况下,空调对氟利昂的使用量是非常小的,所以在空调使用了四年左右的时候再考虑加也没问题。2、...
空调用多长时间需要加氟一次
一般情况下是五年。当出现以下这几种情况时,空调才需要加氟。1、空调的室内机和室外机各有两个接口,当接...
格调生活·C标思享荟:卡萨帝在...
9月12日的郑州龙湖金融岛,夜风轻拂,灯光璀璨。“C标时刻共传奇——卡萨帝思享荟暨20周年品牌盛典郑...
品牌价值破千亿、高端份额持续领...
9月12日,“C标时刻共传奇——卡萨帝思享荟暨20周年品牌盛典郑州站”在郑州龙湖金融岛举办。2026...
空调主板坏了修800还是换新的
空调主板坏了是修还是换新,需要考虑多个因素,以下是一些建议:1. 维修成本:如果维修费用较低,比如 ...
空调开多久需要休息多长时间
问题:空调开多久需要休息多长时间回答:1、在使用空调的过程中,一般空调开7~8个小时左右需要休息2~...
中央空调多长时间清洗一次
1、一般空调开机前清洗一次即可,空调开机中间时段再清洗一次,空调关机时清洗一次,这样比较合理。2、空...
中央空调氟利昂多久加一次
看空调制热和制冷程度,很多人的观点认为氟利昂必须一年放一次,其实这个观点是错误的,理解上面有点偏差,...