

因果推断类问题探索实践
作者 | 陆春晖
出品 | CSDN(ID:CSDNnews)
近些年来,随着机器学习和深度神经网络等人工智能技术的高速发展,人们对数据的理解和应用不再仅仅满足于拟合的准确性,而是开始探索数据内部更深层次的逻辑关系,从“是什么”到“为什么”,因果关系的研究逐步成为热点。2021 年的经济学诺贝尔奖就颁给了 Joshua D. Angrist 和 Guido W. Imbens,以表彰他们在因果关系分析方法上的贡献。
对因果关系的研究可以上溯到古希腊时期,亚里士多德提出四因说,开启了对因果的哲学性思考。英国哲学家大卫·休谟也曾对因果关系的普遍性和必然性进行反思。20 世纪初,美国数学家 Jerzy Neyman 提出了用于因果推断的“潜在结果”(potential outcomes)数学模型,因果推断正式从哲学思考变成数学问题。在此基础上,统计学家 Donald Rubin 和“贝叶斯网络之父” Judea Pearl,分别创建了鲁宾因果模型 Rubin Causal Model (RCM) 和结构因果模型 Structural Causal Model(SCM),成为现代因果推断理论研究的两大基本理论框架。
因果推断(Causal inference)又称因果推理,研究如何更加科学地研究变量间的因果关系。因果关系是一个事件(因)和第二个事件(果)之间的作用关系,属于相关关系的一种。但因果关系又不等同于相关关系,它还需要时间上的先后顺序和合理的机制等。相关关系有三种结构,可以用有向无环图表示,如图1所示,只有一种因果(Causation)结构产生的相关关系是因果关系,其他两种结构会使数据显现出统计相关性,但却不存在因果关系,被称为混淆结构(Counfounder)和对撞结构(Collider)。
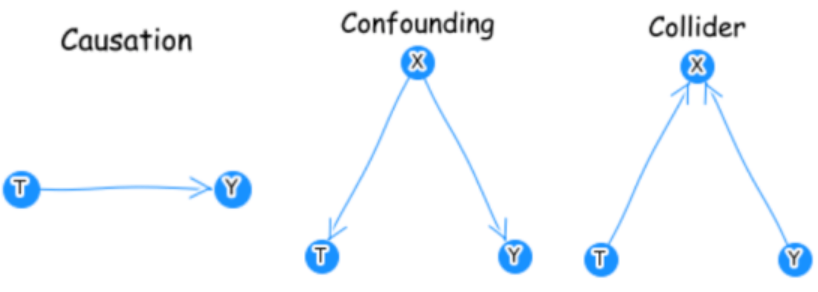
图1 相关关系的几种结构
混淆结构(Counfounder)是指存在变量X,同时影响自变量 T 和因变量 Y,并且能使T和Y之间产生虚假的相关关系。例如巧克力销售量高的国家诺贝尔奖获得者的数量也多,二者之间存在相关性,但巧克力销售量高并不是诺贝尔奖获得者多的原因,它们之间的相关性是由国家的经济教育水平关联的,是伪相关,国家的经济教育水平就是混淆结构中的混淆变量X。
对撞结构(Collider)是指存在变量X,同时受自变量T和因变量Y影响,受到控制的情况下会使自变量和因变量之间产生虚假的相关关系。例如二次世界大战中,幸存返航的飞机中机翼是被击中最多的位置,机尾是被击中最少的位置,但是为了提高飞机的幸存率,应该加强对机尾的防护,因为机尾击中多的飞机都没能返航。是否能返航是弹痕数量多和加强防护两个变量间的对撞变量X。
因此在进行因果推断时,需要从相关关系中排除混淆结构的干扰(只要不对对撞变量进行控制,对撞结构就不会影响因果结构)。
最有效的方法是进行随机对照试验(randomized controlled trial, RCT),也就是让干预变量T进行随机化分配,这样就相当于取消了因果图上干预变量的父节点,混淆变量X不再产生作用。但是在现实世界中,随机对照实验往往成本昂贵,有些时候也会受到社会伦理的约束(药物试验等),因此实际上通常基于观测数据进行因果推断的相关研究。
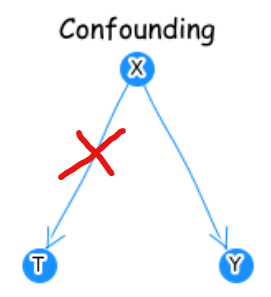
图2 随机对照实验下的混淆结构
数据准备
比赛以“如何优化干预方案能使因果效应最大”为主题,考察参赛者在基于因果推断策略制定问题上的估计能力。比赛准备了两份生成数据,训练集数据train.csv和测试集数据test.csv,数据的生成过程遵从如下因果图。
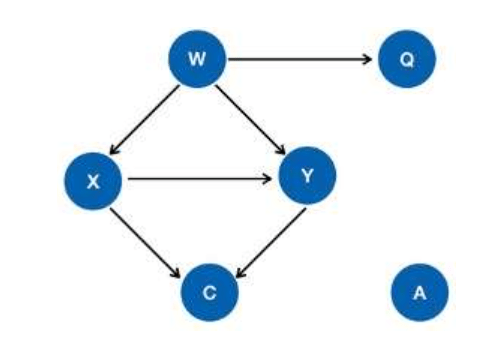
图3 比赛数据生成因果图
其中,X为treatment, 干预方案列,是一个拥有3个值的离散变量。treatment=0视为未施加干预,treatment=1, 2分别视为施加了干预方案1和干预方案2;Y 为 outcome,结果列,是一个连续型变量;其余字母代表了数据集中的其他变量或变量集合,名为‘V_0’, ‘V_1’等的特征列,离散和连续特征均有,但不对选手公布。
测试集数据test.csv 只包含‘V_0’等特征列变量,移除了‘treatment’ 和 ‘outcome’两列。
训练集和测试集的数据样例如图4所示,除去‘treatment’ 和 ‘outcome’,共有40列特征变量,其中有10列离散变量,30列连续变量,有两列特征变量数据值略有缺失,缺失率不超过0.1%。
图4 数据集样例
比赛需要估计训练集和测试集中每个样本在干预方案1和干预方案2下的因果效应,评估指标是干预方案1的因果效应与真实因果效应之间的normalized RMSE (NRMSE),加上干预方案2的因果效应与真实因果效应之间NRMSE,NRMSE越小说明预测结果越准确。
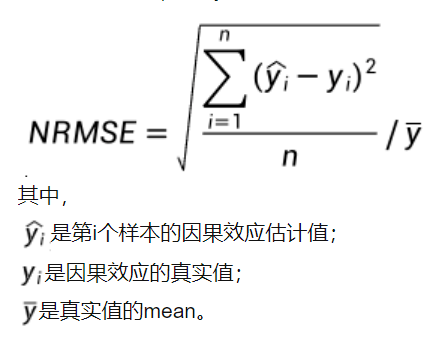
图5 因果效应评估指标NRMSE
并且比赛数据的生成满足三项基本假设:没有未观测到的混淆变量confounder;SUTVA 即每个个体的outcome不被其他个体的treatment影响;每个个体采取每个treatment的概率都不为0或1。
建模思路
在进行建模时首先要清楚目标,本题是要基于给定的观测数据集,估计数据集中每个样本在不同干预方案下的因果效应,这是因果推断领域中的一个研究方向,叫做因果效应估计(Causal Effect Estimation)。
因果效应估计旨在研究原因变量对结果变量的影响程度,例如某种药物对病人的治疗效果如何,目标是在因果结构模型基础上输出对原因变量增量的预测,包括对个体效应的预测ITE (Individual treatment effect)和对群体效应的预测ATE(average treatment effect)等。因果效应估计算法根据是否观测到全部混淆变量分为了两类,前者假设不存在未被观测到的混淆变量,以uplift Modals方法为代表,需要调整混淆变量带来的各种分布不平衡。后者假设存在未被观测到混淆变量,以工具变量法为代表,需要模仿随机试验规避混淆变量的影响。
比赛要求估计单个样本在干预方案1和干预方案2下的因果效应,也就是要实现个体效应的预测ITE (Individual treatment effect)。由于满足没有未观测到的混淆变量confounder的假设,可以考虑使用uplift Modals 方法。
Uplift Modals也叫增益模型,与传统机器学习模型的区别在于它是针对预测Y接受T后的增量uplift进行预测,而不是对Y本身进行预测。结合本次比赛题目背景就是相对于不采用任何干预,预测采用干预方案1的提升,以及采用干预方案2的提升。Uplift Modals有多种建模方式,本文尝试使用九章云极DataCanvas公司YLearn开源项目中实现了的元学习算法(Meta-learning methods)和双重机器学习(Double Machine Learning)算法进行建模。
因果发现旨在挖掘变量之间的因果关系,揭示现象背后的深层原因,例如吸烟是否致癌,目标是建立用于描述变量间因果关系的结构模型,一般用因果图或者结构方程表示。相关算法分为两大类,一类基于组合优化,适用于变量数较少的情况,以PC算法为代表,利用数据中的条件独立性来挖掘潜在的因果结构;另一类基于连续优化,适用于变量数较多,需要高效求解的情况,以NoTears算法为代表,设计了一种连续的针对无环的约束方案,替代传统的组合约束的方式,通过优化反复迭代后得到无环结果。
结论和展望
本文将比赛数据train.csv划分为训练集(30000)和测试集(6188)两部分,在训练集上进行训练,再在测试集上进行验证。
首先不进行因果结构发现,直接用YLearn开源项目的uplift modal的元学习算法和双重机器学习算法,基于40列特征变量进行预测,默认全部特征变量均为混淆变量W,结果如表1所示,可以观察到此时XLearner算法的评估效果最好。
表1直接进行因果评估的结果
接下来先进行因果结构发现,使用gcastle开源项目的NoTears算法进行因果发现的结果如图6所示,可以清楚的发现名称为V_17、V_20、V_27、V_38的特征(图中标号为17、20、27、38),明显属于噪声变量A,可以将其去除。
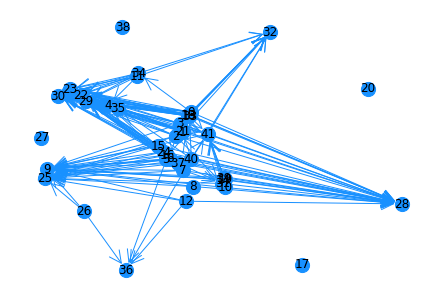
图6 因果发现的关系结构图
去除噪音变量后进行因果效果评估的结果如表2所示,可以看出各种算法,除了SLearner之外,评估的效果均有明显的提升。
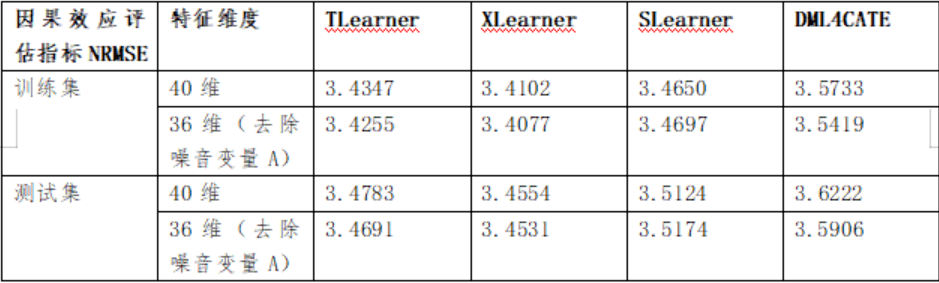
表2去除噪音变量A后因果评估的结果
接下来进一步观察因果结构,从中筛选出衍生变量Q,衍生变量Q是指与混淆向量相关,但是与目标变量无关的变量,进行因果效应评估时不应该使用。图7展示跟目标变量outcome(图中标号41的节点)相关的变量,及这些变量的衍生变量Q,图中标号为[30、23、32、25、9、4、22、29、28、38]。
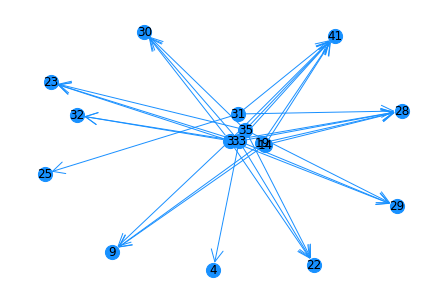
图7 衍生变量
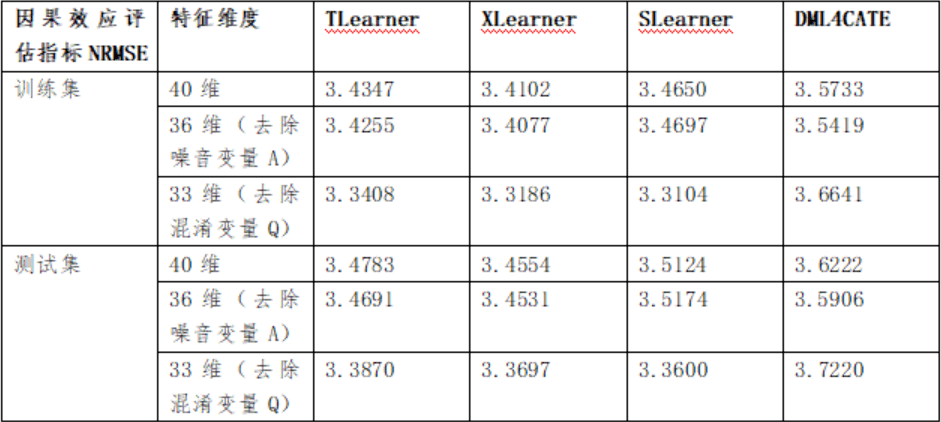
表3去除衍生变量Q后因果评估的结果
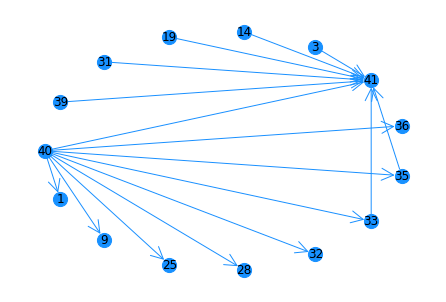
最后应该区分混淆变量W和对撞变量C。将跟目标变量(图中标号41的节点)和操作变量(图中标号40的节点)相关的节点筛选出来如图8所示,发现并没有变量符合混淆变量或者对撞变量的结构,与比赛题目不符,猜测使用的因果结构发现模型精确度还不够。
《2022-2023 中国开发者大调查》重磅启动,欢迎扫描下方二维码,参与问卷调研,更有 iPad 等精美大礼等你拿!
☞抖音回应全国上线外卖:仍在试点中;微软发布 ChatGPT 版搜索引擎;中国计算机图形学巨匠齐东旭教授逝世|极客头条
☞ 国产类 ChatGPT 来了,百度确认将推出文心一言,计划三月面世!
☞ 大厂卷起!Google 发布 ChatGPT 竞品 Bard,微软:我明天有场神秘活动要开!