

如何通过 Scrapyd + ScrapydWeb 简单高效地部署和监控分布式爬虫项目
admin
2023-07-16 02:21:42
0次
安装和配置
- 请先确保所有主机都已经安装和启动 Scrapyd,如果需要远程访问 Scrapyd,则需将 Scrapyd 配置文件中的 bind_address 修改为
bind_address = 0.0.0.0,然后重启 Scrapyd service。 - 开发主机或任一台主机安装 ScrapydWeb:
pip install scrapydweb - 通过运行命令
scrapydweb启动 ScrapydWeb(首次启动将自动在当前工作目录生成配置文件)。 - 启用 HTTP 基本认证(可选):
ENABLE_AUTH = True USERNAME = 'username' PASSWORD = 'password' - 添加 Scrapyd server,支持字符串和元组两种配置格式,支持添加认证信息和分组/标签:
SCRAPYD_SERVERS = [ '127.0.0.1', # 'username:password@localhost:6801#group', ('username', 'password', 'localhost', '6801', 'group'), ] - 运行命令
scrapydweb重启 ScrapydWeb。
访问 web UI
通过浏览器访问并登录 http://127.0.0.1:5000。
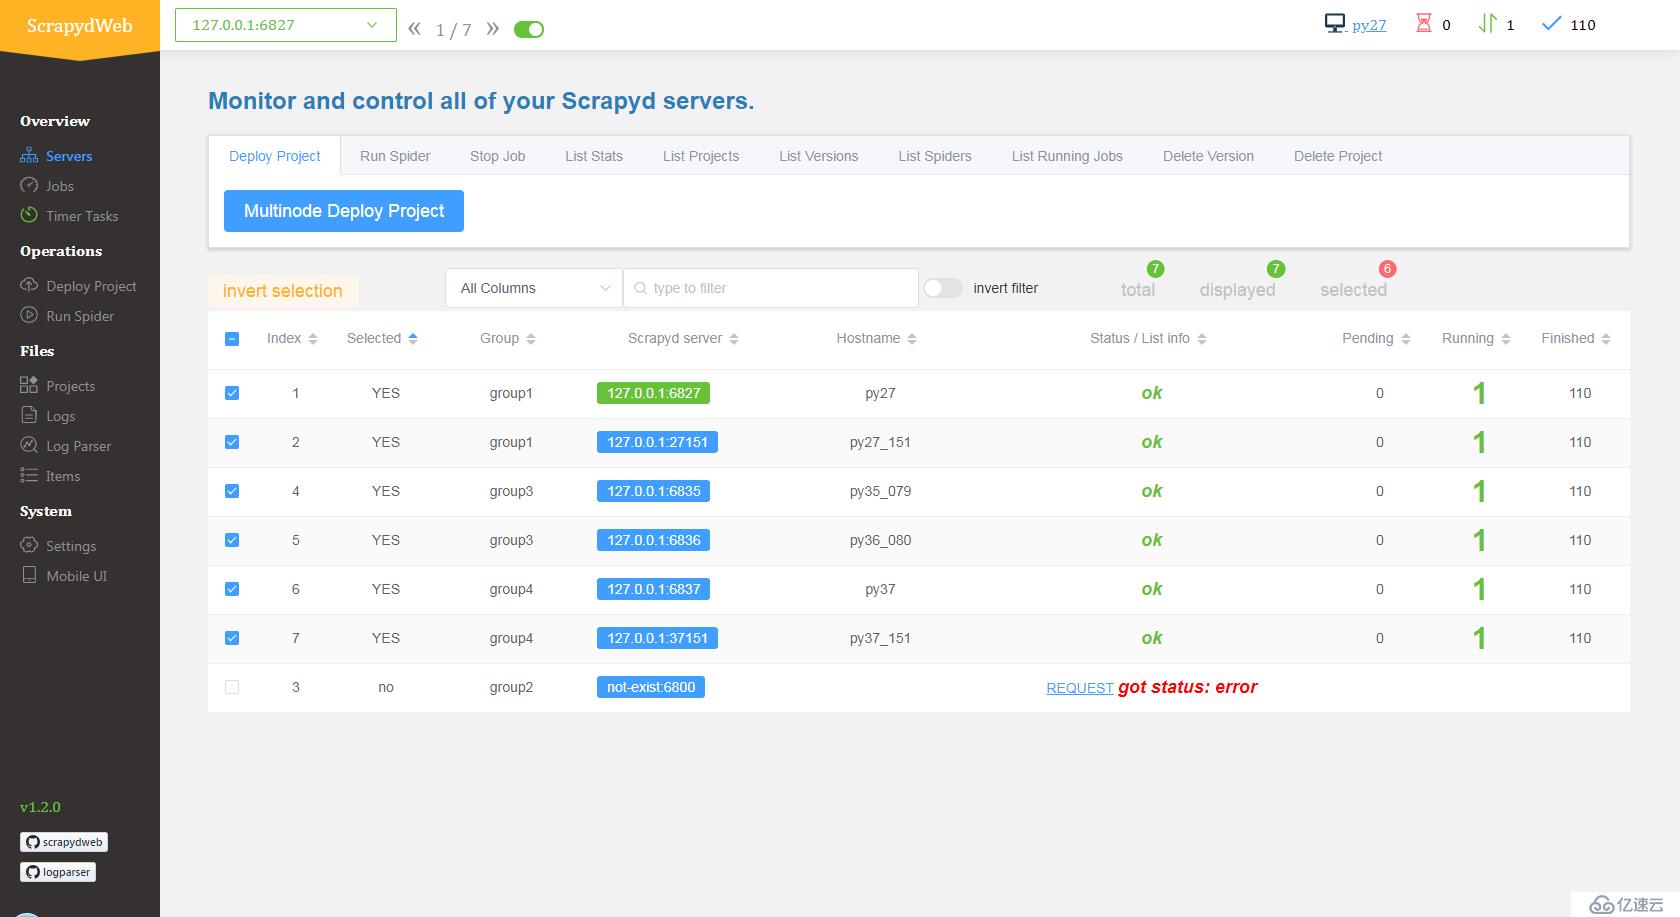
- Servers 页面自动输出所有 Scrapyd server 的运行状态。
- 通过分组和过滤可以自由选择若干台 Scrapyd server,然后在上方 Tabs 标签页中选择 Scrapyd 提供的任一 HTTP JSON API,实现一次操作,批量执行。
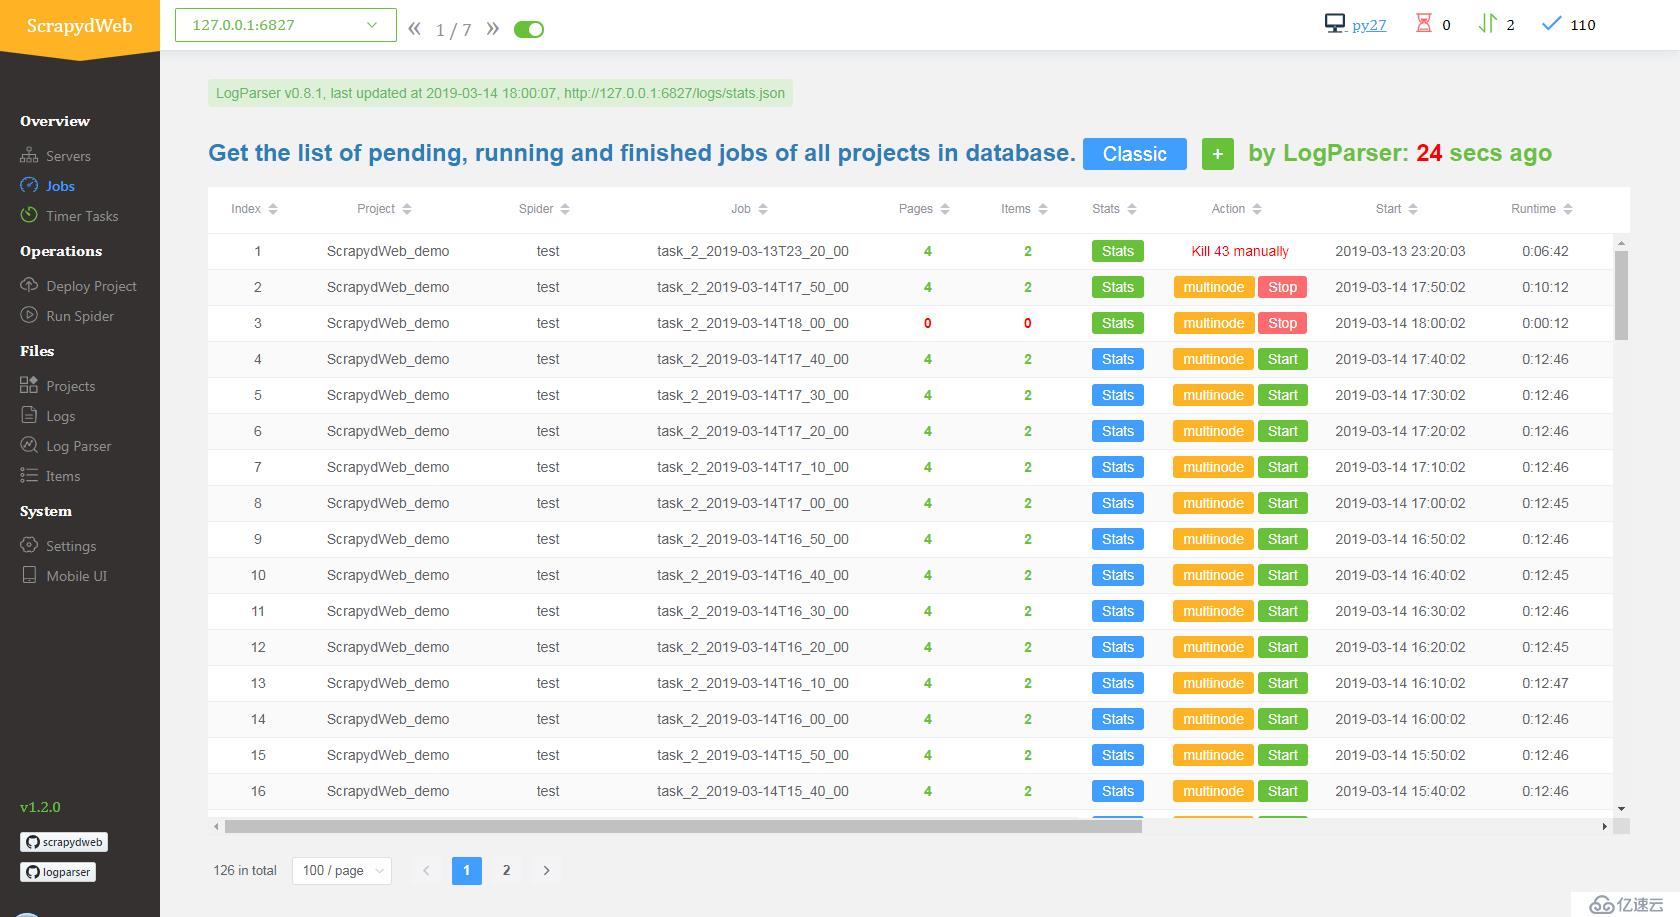
- 通过集成 LogParser,Jobs 页面自动输出爬虫任务的 pages 和 items 数据。
- ScrapydWeb 默认通过定时创建快照将爬虫任务列表信息保存到数据库,即使重启 Scrapyd server 也不会丢失任务信息。(issue 12)
部署项目
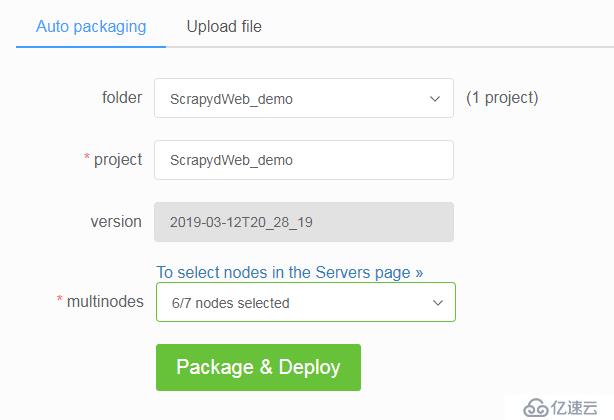
- 通过配置
SCRAPY_PROJECTS_DIR指定 Scrapy 项目开发目录,ScrapydWeb 将自动列出该路径下的所有项目,默认选定最新编辑的项目,选择项目后即可自动打包和部署指定项目。 - 如果 ScrapydWeb 运行在远程服务器上,除了通过当前开发主机上传常规的 egg 文件,也可以将整个项目文件夹添加到 zip/tar/tar.gz 压缩文件后直接上传即可,无需手动打包为 egg 文件。
- 支持一键部署项目到 Scrapyd server 集群。
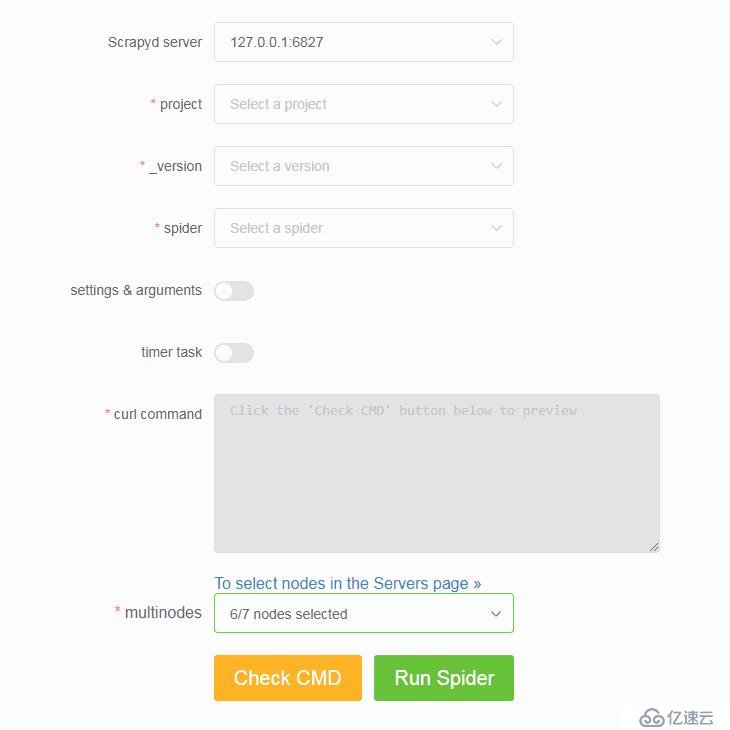
运行爬虫
- 通过下拉框依次选择 project,version 和 spider。
- 支持传入 Scrapy settings 和 spider arguments。
- 支持创建基于 APScheduler 的定时爬虫任务。(如需同时启动大量爬虫任务,则需调整 Scrapyd 配置文件的 max-proc 参数)
- 支持在 Scrapyd server 集群上一键启动分布式爬虫。
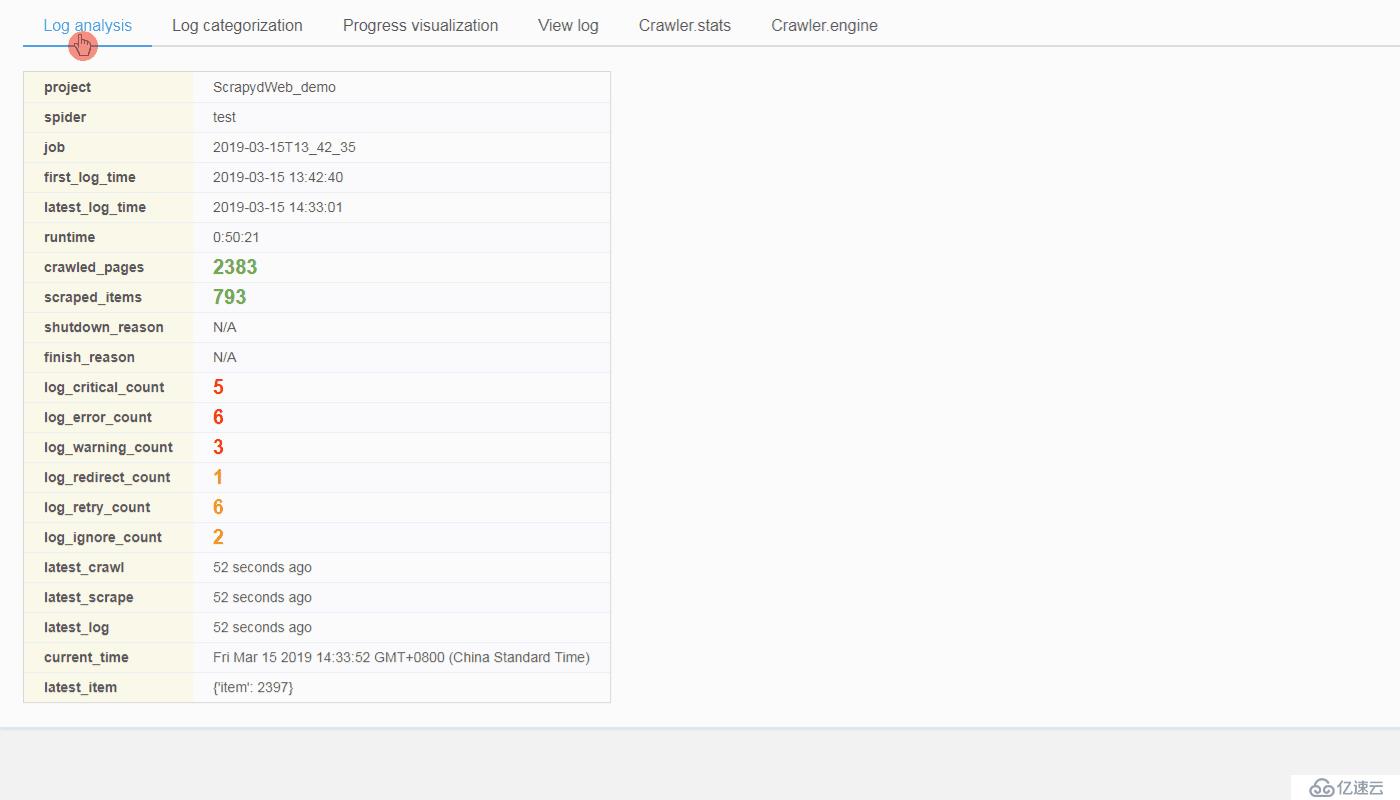
日志分析和可视化
- 如果在同一台主机运行 Scrapyd 和 ScrapydWeb,建议设置
SCRAPYD_LOGS_DIR和ENABLE_LOGPARSER,则启动 ScrapydWeb 时将自动运行 LogParser,该子进程通过定时增量式解析指定目录下的 Scrapy 日志文件以加快 Stats 页面的生成,避免因请求原始日志文件而占用大量内存和网络资源。 - 同理,如果需要管理 Scrapyd server 集群,建议在其余主机单独安装和启动 LogParser。
- 如果安装的 Scrapy 版本不大于 1.5.1,LogParser 将能够自动通过 Scrapy 内建的 Telnet Console 读取 Crawler.stats 和 Crawler.engine 数据,以便掌握 Scrapy 内部运行状态。
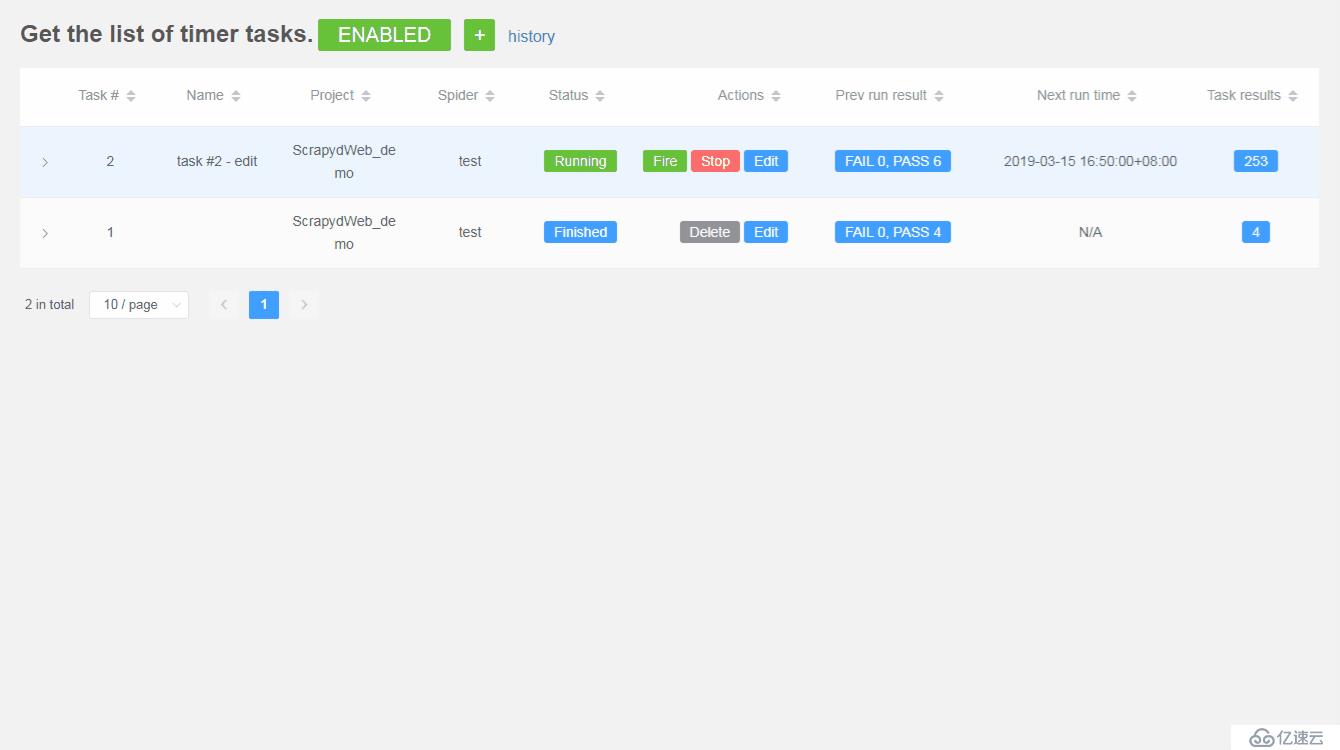
定时爬虫任务
- 支持查看爬虫任务的参数信息,追溯历史记录
- 支持暂停,恢复,触发,停止,编辑和删除任务等操作
邮件通知
通过轮询子进程在后台定时模拟访问 Stats 页面,ScrapydWeb 将在满足特定触发器时根据设定自动停止爬虫任务并发送通知邮件,邮件正文包含当前爬虫任务的统计信息。
- 添加邮箱帐号:
SMTP_SERVER = 'smtp.qq.com'
SMTP_PORT = 465
SMTP_OVER_SSL = True
SMTP_CONNECTION_TIMEOUT = 10
EMAIL_USERNAME = '' # defaults to FROM_ADDR
EMAIL_PASSWORD = 'password'
FROM_ADDR = 'username@qq.com'
TO_ADDRS = [FROM_ADDR]
2. 设置邮件工作时间和基本触发器,以下示例代表:每隔1小时或当某一任务完成时,并且当前时间是工作日的9点,12点和17点,*ScrapydWeb* 将会发送通知邮件。
```python
EMAIL_WORKING_DAYS = [1, 2, 3, 4, 5]
EMAIL_WORKING_HOURS = [9, 12, 17]
ON_JOB_RUNNING_INTERVAL = 3600
ON_JOB_FINISHED = True- 除了基本触发器,ScrapydWeb 还提供了多种触发器用于处理不同类型的 log,包括 'CRITICAL', 'ERROR', 'WARNING', 'REDIRECT', 'RETRY' 和 'IGNORE'等。
LOG_CRITICAL_THRESHOLD = 3
LOG_CRITICAL_TRIGGER_STOP = True
LOG_CRITICAL_TRIGGER_FORCESTOP = False
# ...
LOG_IGNORE_TRIGGER_FORCESTOP = False
以上示例代表:当日志中出现3条或以上的 critical 级别的 log 时,ScrapydWeb 将自动停止当前任务,如果当前时间在邮件工作时间内,则同时发送通知邮件。
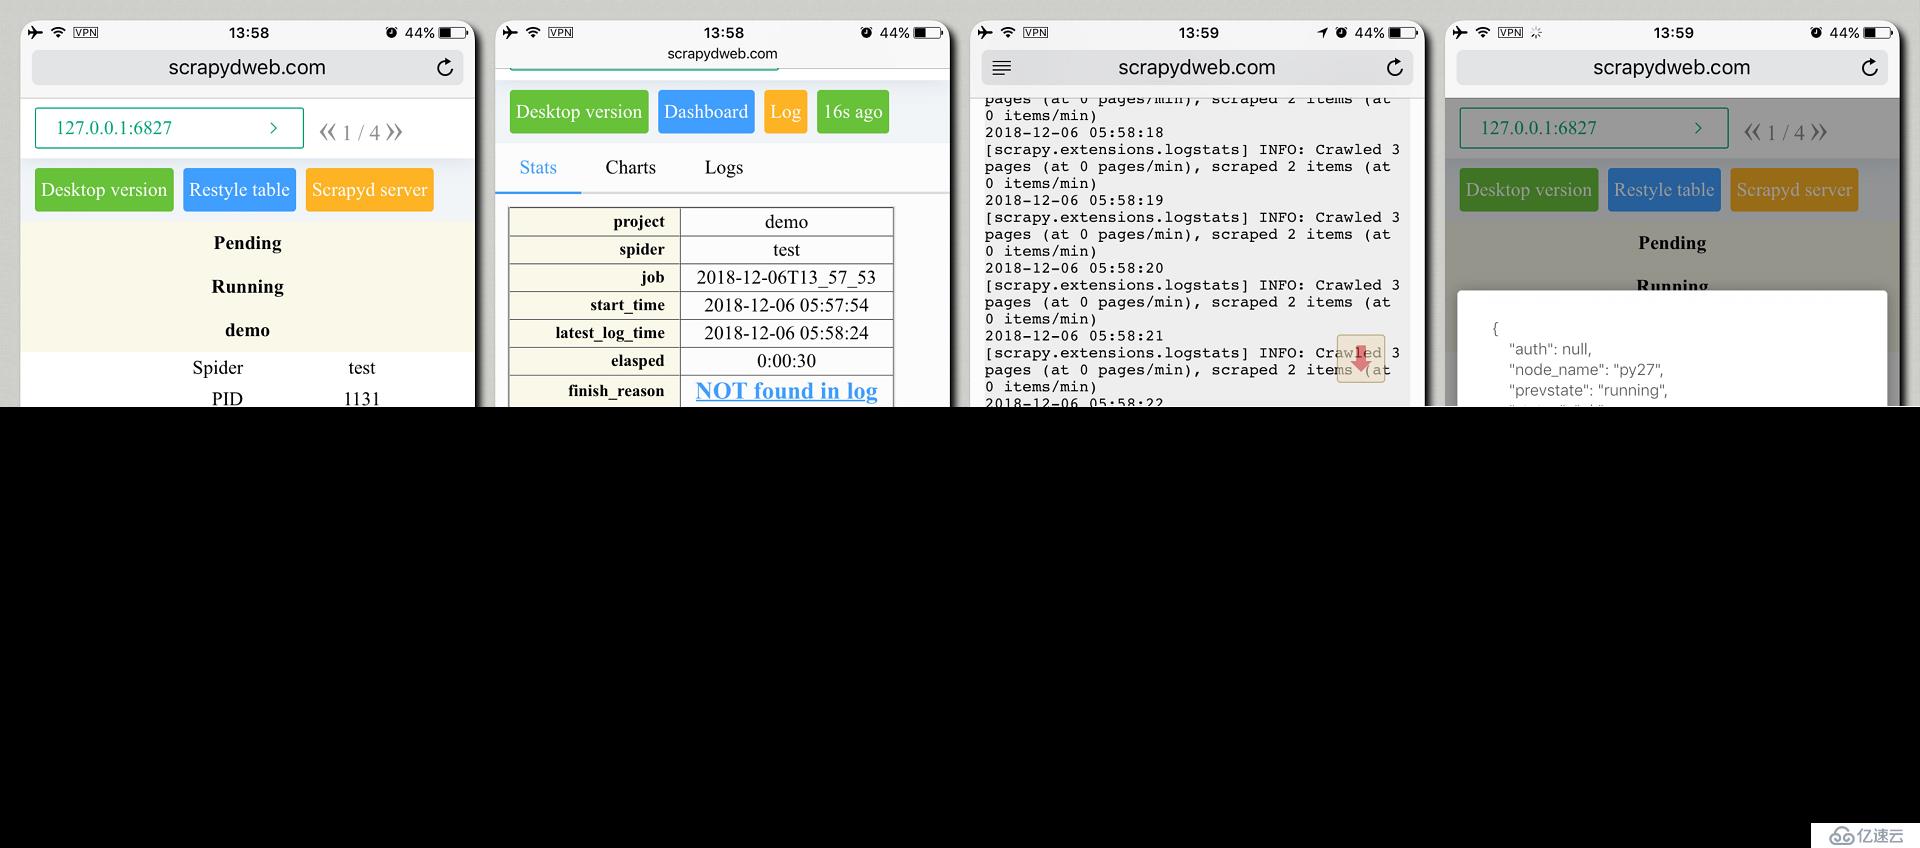
移动端 UI
GitHub 开源
my8100/scrapydweb
下一篇:爬取豆瓣的tp250电影名单
相关内容
热门资讯
空调连续工作多久需要停机休息
空调连续工作的时间取决于多个因素,包括空调的型号、功率、使用环境和维护情况等。一般来说,空调可以连续...
空调哪个符号是除湿的
空调除湿功能通常用一个水滴形状的符号表示。不同品牌和型号的空调遥控器可能会有所差异,但一般来说,除湿...
格力空调多长时间加一次氟利昂
1、一般情况下,空调对氟利昂的使用量是非常小的,所以在空调使用了四年左右的时候再考虑加也没问题。2、...
空调用多长时间需要加氟一次
一般情况下是五年。当出现以下这几种情况时,空调才需要加氟。1、空调的室内机和室外机各有两个接口,当接...
格调生活·C标思享荟:卡萨帝在...
9月12日的郑州龙湖金融岛,夜风轻拂,灯光璀璨。“C标时刻共传奇——卡萨帝思享荟暨20周年品牌盛典郑...
品牌价值破千亿、高端份额持续领...
9月12日,“C标时刻共传奇——卡萨帝思享荟暨20周年品牌盛典郑州站”在郑州龙湖金融岛举办。2026...
空调主板坏了修800还是换新的
空调主板坏了是修还是换新,需要考虑多个因素,以下是一些建议:1. 维修成本:如果维修费用较低,比如 ...
空调开多久需要休息多长时间
问题:空调开多久需要休息多长时间回答:1、在使用空调的过程中,一般空调开7~8个小时左右需要休息2~...
中央空调多长时间清洗一次
1、一般空调开机前清洗一次即可,空调开机中间时段再清洗一次,空调关机时清洗一次,这样比较合理。2、空...
中央空调氟利昂多久加一次
看空调制热和制冷程度,很多人的观点认为氟利昂必须一年放一次,其实这个观点是错误的,理解上面有点偏差,...