

python3使用cookie免登录爬取附件并下载
admin
2023-07-10 04:43:16
0次
前言
由于一些论坛不登录验证,就不能查看帖子的内容和附件,所以需要登录验证,如果在代码中添加登录验证,那就增加了代码的复杂度,所以可以结合cookie来登录然后爬取需要的资料
cookie的获取
- 使用chrome,登录后在开发工具里查取

#!/usr/bin/env python
# -*- coding:utf-8 -*-
"""
@author:Aiker Zhao
@file:jianli.py
@time:下午10:50
"""
import os
import re

import requests
from bs4 import BeautifulSoup
from requests.exceptions import RequestException
from hashlib import md5

headers = {
    'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.86 Safari/537.36',
    'Cookie': 'PHPSESSID=ui7unwxc3yf4glbdaqmat2ee00; __cfduid=de4fa38a23ad640f0bcdb4313560af62e1543723208; ape__Session=ui7uxxxxdfd4glbdaqmat2ee00; _ga=GA1.2.176343230234.1552443854'

}

def get_content():
    url = 'http://ask.xxxx.com/question/xxxx'   # url
    response = requests.get(url, headers=headers).text.replace('', '')
    soup = BeautifulSoup(response, 'lxml')
    # div = soup.select('#aw-mod-body ueditor-p-reset')
    pattern = re.compile('(.*?)', re.S)
    p = soup.find_all('a')
    for item in p:
        # print(str(item))
        result = re.findall(pattern, str(item))
        if result:
            # print(result)
            for i in result:
                url, name = i
                # print(i)
                yield {
                    'url': url,
                    'name': name
                }

def download_doc(url, name):
    print('正在下载', name, url)
    try:
        response = requests.get(url, headers=headers)
        if response.status_code == 200:
            save_doc(response.content, name)
        return None
    except RequestException:
        print('请求文档出错', url)
        return None

def save_doc(content, name):
    try:
        if name:
            name_1 = re.sub('[:?!!:?【】]', '', name).split('.')[0]  # 替换title中的特殊字符,避免建立文件出错
            name_2 = name.split('.')[-1]
            dir = 'z:\\jianli2\\'
            if os.path.exists(dir):
                pass
            else:
                os.mkdir(dir)
            file_path = '{0}/{1}.{2}'.format(dir, name_1 + md5(content).hexdigest(), name_2)
            # file_path = '{0}/{1}'.format(dir, name)
            if not os.path.exists(file_path):
                with open(file_path, 'wb') as f:
                    f.write(content)
                    f.close()
    except OSError:
        pass

def main():
    # get_content()
    for f in get_content():
        url = f.get('url')
        name = f.get('name')
        download_doc(url, name)

if __name__ == '__main__':
    main()
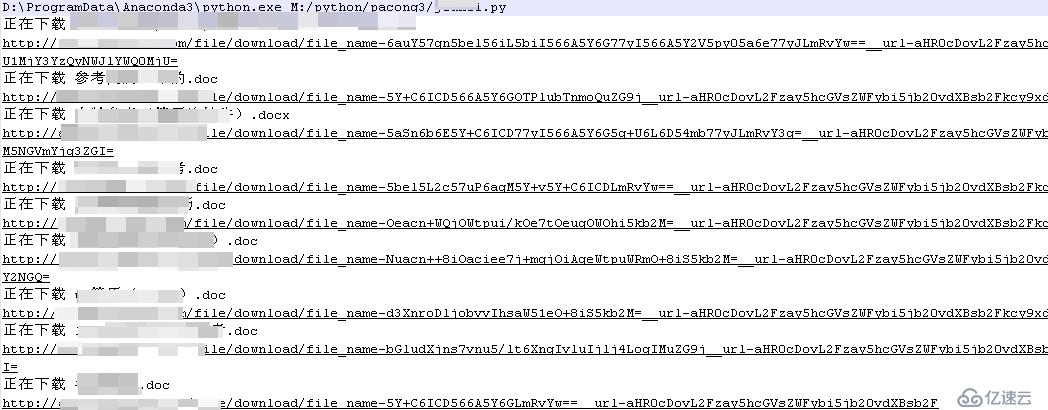
运行脚本
相关内容
热门资讯
空调连续工作多久需要停机休息
空调连续工作的时间取决于多个因素,包括空调的型号、功率、使用环境和维护情况等。一般来说,空调可以连续...
空调哪个符号是除湿的
空调除湿功能通常用一个水滴形状的符号表示。不同品牌和型号的空调遥控器可能会有所差异,但一般来说,除湿...
格力空调多长时间加一次氟利昂
1、一般情况下,空调对氟利昂的使用量是非常小的,所以在空调使用了四年左右的时候再考虑加也没问题。2、...
空调用多长时间需要加氟一次
一般情况下是五年。当出现以下这几种情况时,空调才需要加氟。1、空调的室内机和室外机各有两个接口,当接...
格调生活·C标思享荟:卡萨帝在...
9月12日的郑州龙湖金融岛,夜风轻拂,灯光璀璨。“C标时刻共传奇——卡萨帝思享荟暨20周年品牌盛典郑...
品牌价值破千亿、高端份额持续领...
9月12日,“C标时刻共传奇——卡萨帝思享荟暨20周年品牌盛典郑州站”在郑州龙湖金融岛举办。2026...
空调主板坏了修800还是换新的
空调主板坏了是修还是换新,需要考虑多个因素,以下是一些建议:1. 维修成本:如果维修费用较低,比如 ...
空调开多久需要休息多长时间
问题:空调开多久需要休息多长时间回答:1、在使用空调的过程中,一般空调开7~8个小时左右需要休息2~...
中央空调多长时间清洗一次
1、一般空调开机前清洗一次即可,空调开机中间时段再清洗一次,空调关机时清洗一次,这样比较合理。2、空...
中央空调氟利昂多久加一次
看空调制热和制冷程度,很多人的观点认为氟利昂必须一年放一次,其实这个观点是错误的,理解上面有点偏差,...