

k8s,Kubernetes环境搭建,集群搭建,1个mster,2个node
安装虚拟机
1.安装3台虚拟机,或者使用其他物理机都OK;
2.三台IP地址分别为:192.168.222.135,192.168.222.139,192.168.222.140
2.设置hostname,master节点设置
hostnamectl set-hostname master3.两个node节点设置
hostnamectl set-hostname node14.退出shell重新登录
安装组件
1.在三台服务器上都安装docker、kubelet、kubeadm、kubectl,这里有个脚本,大家可以拿来使用。
 ~]# vi setup.sh
 以下内容复制进文件
 #/bin/sh

# install some tools
sudo yum install -y vim telnet bind-utils wget

sudo bash -c 'cat < /etc/yum.repos.d/kubernetes.repo
[kubernetes]
name=Kubernetes
baseurl=http://mirrors.aliyun.com/kubernetes/yum/repos/kubernetes-el7-x86_64
enabled=1
gpgcheck=1
repo_gpgcheck=1
gpgkey=http://mirrors.aliyun.com/kubernetes/yum/doc/yum-key.gpg http://mirrors.aliyun.com/kubernetes/yum/doc/rpm-package-key.gpg
EOF'

# install and start docker
sudo yum install -y docker
sudo systemctl enable docker && sudo systemctl start docker
# Verify docker version is 1.12 and greater.

sudo setenforce 0

# install kubeadm, kubectl, and kubelet.
sudo yum install -y kubelet kubeadm kubectl

sudo bash -c 'cat <  /etc/sysctl.d/k8s.conf
net.bridge.bridge-nf-call-ip6tables = 1
net.bridge.bridge-nf-call-iptables = 1
net.ipv4.ip_forward=1
EOF'
sudo sysctl --system

sudo systemctl stop firewalld
sudo systemctl disable firewalld
sudo swapoff -a
sudo systemctl enable kubelet && sudo systemctl start kubelet
2.将setup.sh复制到另外两台服务器上
scp setup.sh root@192.168.222.139:/root/
scp setup.sh root@192.168.222.140:/root/
3.分别在三台服务器上执行这个脚本,脚本其实就是安装一些组件,大家都应该能看得懂。
sh setup.sh安装确认
分别在三台机器上运行以下命令,确认是否安装完毕需要的组件
[root@node2 ~]# which kubeadm
/usr/bin/kubeadm
[root@node2 ~]# which kubelet
/usr/bin/kubelet
[root@node2 ~]# which kubectl
/usr/local/bin/kubectl
[root@node2 ~]# docker version
Client:
 Version:         1.13.1
 API version:     1.26
 Package version: docker-1.13.1-94.gitb2f74b2.el7.centos.x86_64
 Go version:      go1.10.3
 Git commit:      b2f74b2/1.13.1
 Built:           Tue Mar 12 10:27:24 2019
 OS/Arch:         linux/amd64

Server:
 Version:         1.13.1
 API version:     1.26 (minimum version 1.12)
 Package version: docker-1.13.1-94.gitb2f74b2.el7.centos.x86_64
 Go version:      go1.10.3
 Git commit:      b2f74b2/1.13.1
 Built:           Tue Mar 12 10:27:24 2019
 OS/Arch:         linux/amd64
 Experimental:    false
确认没问题后进入下一个步骤
master配置
1.主节点上进行kubeadmin init
sudo kubeadm init --pod-network-cidr 172.100.0.0/16 --apiserver-advertise-address 192.168.222.135
#--pod-network-cidr:pod节点的网段
#--apiserver-advertise-address:apiserver的IP地址,这里写成master节点的IP即可
#-**-apiserver-cert-extra-sans: 如果需要使用公网IP,加上这一条,并且后面加上你的公网IP地址**
2.如果发现拉取镜像失败,我是拉取失败了~~~~ 所以去百度了一下,我们通过 docker.io/mirrorgooglecontainers 中转一下,运行以下命令,直接复制即可
kubeadm config images list |sed -e 's/^/docker pull /g' -e 's#k8s.gcr.io#docker.io/mirrorgooglecontainers#g' |sh -x
docker images |grep mirrorgooglecontainers |awk '{print "docker tag ",$1":"$2,$1":"$2}' |sed -e 's#docker.io/mirrorgooglecontainers#k8s.gcr.io#2' |sh -x
docker images |grep mirrorgooglecontainers |awk '{print "docker rmi ", $1":"$2}' |sh -x
docker pull coredns/coredns:1.2.2
docker tag coredns/coredns:1.2.2 k8s.gcr.io/coredns:1.3.1
docker rmi coredns/coredns:1.2.2
查看镜像列表,没毛病,如果发现init还报错的话,按照kubeadm的报错信息更改下docker镜像的tag,具体各位百度下吧
[root@master ~]# docker images
REPOSITORY                           TAG                 IMAGE ID            CREATED             SIZE
k8s.gcr.io/kube-proxy                v1.14.1             20a2d7035165        2 days ago          82.1 MB
k8s.gcr.io/kube-apiserver            v1.14.1             cfaa4ad74c37        2 days ago          210 MB
k8s.gcr.io/kube-controller-manager   v1.14.1             efb3887b411d        2 days ago          158 MB
k8s.gcr.io/kube-scheduler            v1.14.1             8931473d5bdb        2 days ago          81.6 MB
k8s.gcr.io/etcd                      3.3.10              2c4adeb21b4f        4 months ago        258 MB
k8s.gcr.io/coredns                   1.3.1               367cdc8433a4        7 months ago        39.2 MB
k8s.gcr.io/pause                     3.1                 da86e6ba6ca1        15 months ago       742 kB
3.kubeadm输出的主要信息,如下
Your Kubernetes control-plane has initialized successfully!

To start using your cluster, you need to run the following as a regular user:

  mkdir -p $HOME/.kube
  sudo cp -i /etc/kubernetes/admin.conf $HOME/.kube/config
  sudo chown $(id -u):$(id -g) $HOME/.kube/config

You should now deploy a pod network to the cluster.
Run "kubectl apply -f [podnetwork].yaml" with one of the options listed at:
  https://kubernetes.io/docs/concepts/cluster-administration/addons/

Then you can join any number of worker nodes by running the following on each as root:

kubeadm join 192.168.222.135:6443 --token srbxk3.x6xo6nhv3a4ng08m \
    --discovery-token-ca-cert-hash sha256:b302232cbf1c5f3d418cea5553b641181d4bb384aadbce9b1d97b37cde477773
4.运行kubeadm配置
  mkdir -p $HOME/.kube
  sudo cp -i /etc/kubernetes/admin.conf $HOME/.kube/config
  sudo chown $(id -u):$(id -g) $HOME/.kube/config
5.安装网络插件
kubectl apply -f "https://cloud.weave.works/k8s/net?k8s-version=$(kubectl version | base64 | tr -d '\n')"6.确认是否安装完成,查看pod内是否有weave-net即可
[root@master ~]# kubectl get pod --all-namespaces
NAMESPACE     NAME                             READY   STATUS    RESTARTS   AGE
kube-system   coredns-fb8b8dccf-glszh          1/1     Running   0          23m
kube-system   coredns-fb8b8dccf-xcmtx          1/1     Running   0          23m
kube-system   etcd-master                      1/1     Running   0          22m
kube-system   kube-apiserver-master            1/1     Running   0          22m
kube-system   kube-controller-manager-master   1/1     Running   0          22m
kube-system   kube-proxy-z84wh                 1/1     Running   0          23m
kube-system   kube-scheduler-master            1/1     Running   0          22m
kube-system   weave-net-phwjz                  2/2     Running   0          95s
加入node
1.在两台node上分别运行主要信息内的命令,如下(这个不能复制,需要查看自己的kubeadm输出的信息):
kubeadm join 192.168.222.135:6443 --token srbxk3.x6xo6nhv3a4ng08m \
    --discovery-token-ca-cert-hash sha256:b302232cbf1c5f3d418cea5553b641181d4bb384aadbce9b1d97b37cde477773
2.加入节点之后,发现node一直处于notready状态,好纠结
[root@master bin]# kubectl get node
NAME     STATUS     ROLES    AGE    VERSION
master   Ready      master   167m   v1.14.1
node1    NotReady      142m   v1.14.1
node2    NotReady      142m   v1.14.1
3.查看pod节点,发现weave没启动
[root@master bin]# kubectl get pods --all-namespaces
NAMESPACE     NAME                             READY   STATUS              RESTARTS   AGE
kube-system   coredns-fb8b8dccf-glszh          1/1     Running             1          168m
kube-system   coredns-fb8b8dccf-xcmtx          1/1     Running             1          168m
kube-system   etcd-master                      1/1     Running             1          167m
kube-system   kube-apiserver-master            1/1     Running             1          167m
kube-system   kube-controller-manager-master   1/1     Running             1          167m
kube-system   kube-proxy-bq2rf                 0/1     ContainerCreating   0          143m
kube-system   kube-proxy-m8f7z                 0/1     ContainerCreating   0          143m
kube-system   kube-proxy-z84wh                 1/1     Running             1          168m
kube-system   kube-scheduler-master            1/1     Running             1          167m
kube-system   weave-net-8xmpx                  0/2     ContainerCreating   0          143m
kube-system   weave-net-phwjz                  2/2     Running             4          147m
kube-system   weave-net-xwqwm                  0/2     ContainerCreating   0          143m
4.使用describe pods发现报错,没有拉取镜像,可是本机上已经有k8s.gcr.io/pause:3.1 镜像了,在不懈的努力下,终于知道了,原来node节点上也需要该镜像
kubectl describe pods --namespace=kube-system weave-net-8xmpx

Events:
  Type     Reason                  Age                   From            Message
  ----     ------                  ----                  ----            -------
  Warning  FailedCreatePodSandBox  77m (x8 over 120m)    kubelet, node2  Failed create pod sandbox: rpc error: code = Unknown desc = failed pulling image "k8s.gcr.io/pause:3.1": Get https://k8s.gcr.io/v1/_ping: dial tcp 64.233.189.82:443: connect: connection refused
  Warning  FailedCreatePodSandBox  32m (x9 over 91m)     kubelet, node2  Failed create pod sandbox: rpc error: code = Unknown desc = failed pulling image "k8s.gcr.io/pause:3.1": Get https://k8s.gcr.io/v1/_ping: dial tcp 64.233.188.82:443: connect: connection refused
  Warning  FailedCreatePodSandBox  22m (x23 over 133m)   kubelet, node2  Failed create pod sandbox: rpc error: code = Unknown desc = failed pulling image "k8s.gcr.io/pause:3.1": Get https://k8s.gcr.io/v1/_ping: dial tcp 108.177.97.82:443: connect: connection refused
  Warning  FailedCreatePodSandBox  17m (x56 over 125m)   kubelet, node2  Failed create pod sandbox: rpc error: code = Unknown desc = failed pulling image "k8s.gcr.io/pause:3.1": Get https://k8s.gcr.io/v1/_ping: dial tcp 74.125.203.82:443: connect: connection refused
  Warning  FailedCreatePodSandBox  12m (x24 over 110m)   kubelet, node2  Failed create pod sandbox: rpc error: code = Unknown desc = failed pulling image "k8s.gcr.io/pause:3.1": Get https://k8s.gcr.io/v1/_ping: dial tcp 74.125.204.82:443: connect: connection refused
  Warning  FailedCreatePodSandBox  2m31s (x20 over 96m)  kubelet, node2  Failed create pod sandbox: rpc error: code = Unknown desc = failed pulling image "k8s.gcr.io/pause:3.1": Get https://k8s.gcr.io/v1/_ping: dial tcp 108.177.125.82:443: connect: connection refused
5.node节点下载该镜像,分别运行以下命令,执行后发现还需要k8s.gcr.io/kube-proxy:v1.14.1 该镜像,那么一起处理吧(pull的镜像版本可以自己改,不改的话根据我的命令执行也可以)。
docker pull mirrorgooglecontainers/pause:3.1
docker tag docker.io/mirrorgooglecontainers/pause:3.1  k8s.gcr.io/pause:3.1
docker pull mirrorgooglecontainers/kube-proxy-amd64:v1.11.3
docker tag docker.io/mirrorgooglecontainers/kube-proxy-amd64:v1.11.3 k8s.gcr.io/kube-proxy:v1.14.1
6.大功告成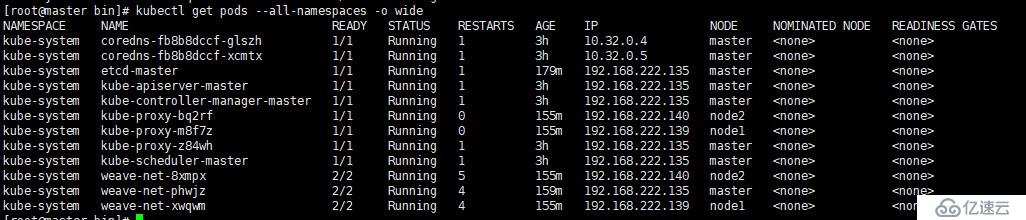
创建一个pod测试
1.配置一个yml文件
vim nginx.yml
apiVersion: v1
kind: Pod
metadata:
  name: nginx
  labels:
    app: web
spec:
  containers:
  - name: nginx
    image: nginx
    ports:
    - containerPort: 80
2.创建pod
kubectl create -f nginx.yml3.查看IP并访问
[root@master ~]# kubectl get pod -o wide
NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES
nginx 1/1 Running 0 4m11s 10.44.0.1 node1
[root@master ~]# curl 10.44.0.1
Welcome to nginx!
Welcome to nginx!
If you see this page, the nginx web server is successfully installed and
working. Further configuration is required.
For online documentation and support please refer to
nginx.org.
Commercial support is available at
nginx.com.
Thank you for using nginx.
感谢大家观看