

利用Python怎么将pdf表格导入到excel
创始人
2024-12-29 04:42:21
0次
避免CV大法
pdf 文件的表格的数据可以复制,但是这是一项非常繁琐的事情。所以我首先考虑的是,Python 可否帮助我们高效且规范地读取 pdf 中的表格数据。所以一顿的检索,发现了一个比较优质处理 pdf 的库:pdfplumber,当然这个库需要大家 pip install pdfplumber 去进行安装。
导入 pdfplumber 库
通过 pdfplumber.open() 函数 获取 mt2018.pdf 文件对象
通过该 对象.pages 获取 pdf 每页的对象,截取我们需要的页对象即可
通过 页对象.extract_tables() 获取表格数据(若需要获取文本:页对象.extract_text())
代码实现:
import pdfplumber


# 获取 pdf 文件对象
pdf_mt = pdfplumber.open("mt2018.pdf")

# 因为我需要获取的资产负债表在 51-53页 但是索引从0开始 所以切片取 50-52即可
for pdf_pg in pdf_mt.pages[50:53]:

  # 只提取当前页表格数据
  print(pdf_pg.extract_tables())


--------------------------------------------------------------------------
结果比较多,截取一部分:
[[['项目', '附注', '期末余额', '期初余额'], ['流动资产:', '', '', ''], ['货币资金', '1', '112,074,791,420.06', '87,868,869,913.34'], ['结算备付金', '', '', ''], ['拆出资金', '', '', ''], ['以公允价值计量且其变动计入当\n期损益的金融资产', '', '', ''], ['衍生金融资产', '', '', ''], ['应收票据及应收账款', '2', '563,739,710.00', '1,221,706,039.00']]]
将完整表保存到 csv 文件中
我们发现,返回的数据集是一个三维的列表。那么在我们平时处理的 excel 表格数据(行与列)都是二维的数据。那么,这多出的一维是什么呢?其实就是我们的夜[页]~ 再来一个循环取出二维数据进行保存即可
for pdf_pg in pdf_mt.pages[50:53]:
  for pdf_tb in pdf_pg.extract_tables():
    print(pdf_tb)

------------------------------------------------------------------------------
结果比较多,截取一部分:
[['项目', '附注', '期末余额', '期初余额'], ['流动资产:', '', '', ''], ['货币资金', '1', '112,074,791,420.06', '87,868,869,913.34'], ['结算备付金', '', '', ''], ['拆出资金', '', '', ''], ['以公允价值计量且其变动计入当\n期损益的金融资产', '', '', ''], ['衍生金融资产', '', '', ''], ['应收票据及应收账款', '2', '563,739,710.00', '1,221,706,039.00']]
但是,真的那么简单吗?这时,我们就需要细品我们的 pdf 了,如下图
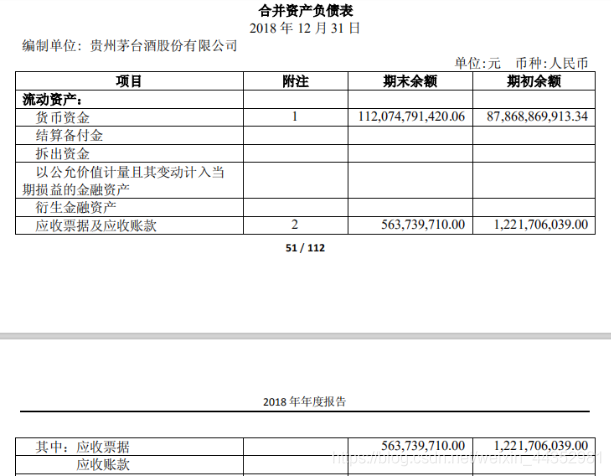
我们发现,一张完整的资产负债表分布在多页上。也就是说,每一页的里面的表格数据都是一个三维的列表,所以我们保存数据的时候,需要让其有共同的表头(列索引),并且进行拼接。
那必须就要强推我们的 pandas 了,pandas.DataFrame() 非常完美的创建表格式的二维数组,以及指定列索引(表头)。包括可以直接 使用 df.append() 进行共同表头数据的堆叠拼接。
import pdfplumber
import pandas as pd
import numpy as np

# 创建仅有表头的 dataframe 数组
pdf_df = pd.DataFrame(columns=['项目', '附注', '期末余额', '期初余额'])

# 获取 pdf 文件对象
pdf_mt = pdfplumber.open("mt2018.pdf")

# 因为我需要获取的资产负债表在 51-53页 但是索引从0开始 所以切片取 50-52即可
for pdf_pg in pdf_mt.pages[50:53]:

  # 获取二维列表
  for pdf_tb in pdf_pg.extract_tables():

    # 将其拼接
    pdf_df = pdf_df.append(pd.DataFrame(np.array(pdf_tb),columns=['项目', '附注', '期末余额', '期初余额']))

# 显示后五条
pdf_df.tail()
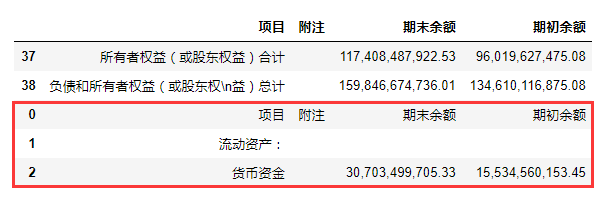
dataframe数据输出如下:
pdf 53页如下:
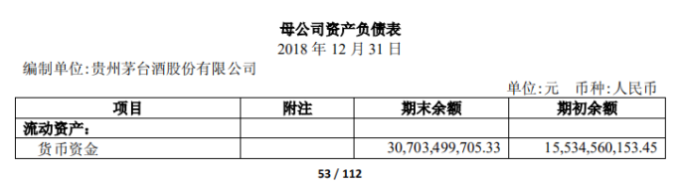
实际上,大家也发现,我们获取的最后一页的数据还有一部分是另一个表的,所以我们需要将其去除,并且有序的设置行索引,再保存到 csv 文件中。
# 去除后三行
pdf_df = pdf_df.iloc[:-3,:]

# 重置索引
pdf_df = pdf_df.reset_index(drop=True)

# 保存到 csv 文件中
pdf_df.to_csv("mt_2018.csv")
相关内容
热门资讯
空调连续工作多久需要停机休息
空调连续工作的时间取决于多个因素,包括空调的型号、功率、使用环境和维护情况等。一般来说,空调可以连续...
空调哪个符号是除湿的
空调除湿功能通常用一个水滴形状的符号表示。不同品牌和型号的空调遥控器可能会有所差异,但一般来说,除湿...
格力空调多长时间加一次氟利昂
1、一般情况下,空调对氟利昂的使用量是非常小的,所以在空调使用了四年左右的时候再考虑加也没问题。2、...
空调用多长时间需要加氟一次
一般情况下是五年。当出现以下这几种情况时,空调才需要加氟。1、空调的室内机和室外机各有两个接口,当接...
格调生活·C标思享荟:卡萨帝在...
9月12日的郑州龙湖金融岛,夜风轻拂,灯光璀璨。“C标时刻共传奇——卡萨帝思享荟暨20周年品牌盛典郑...
品牌价值破千亿、高端份额持续领...
9月12日,“C标时刻共传奇——卡萨帝思享荟暨20周年品牌盛典郑州站”在郑州龙湖金融岛举办。2026...
空调主板坏了修800还是换新的
空调主板坏了是修还是换新,需要考虑多个因素,以下是一些建议:1. 维修成本:如果维修费用较低,比如 ...
空调开多久需要休息多长时间
问题:空调开多久需要休息多长时间回答:1、在使用空调的过程中,一般空调开7~8个小时左右需要休息2~...
中央空调多长时间清洗一次
1、一般空调开机前清洗一次即可,空调开机中间时段再清洗一次,空调关机时清洗一次,这样比较合理。2、空...
中央空调氟利昂多久加一次
看空调制热和制冷程度,很多人的观点认为氟利昂必须一年放一次,其实这个观点是错误的,理解上面有点偏差,...