

使用60行python代码写一个简单的笔趣阁爬虫
创始人
2024-12-28 13:23:05
0次
文章目录
系列文章目录
前言
一、网页解析
二、代码填写
1.获取Html及写入方法
2.其余代码
总结
前言
利用python写一个简单的笔趣阁爬虫,根据输入的小说网址爬取整个小说并保存到txt文件。爬虫用到了BeautifulSoup库的select方法
结果如图所示: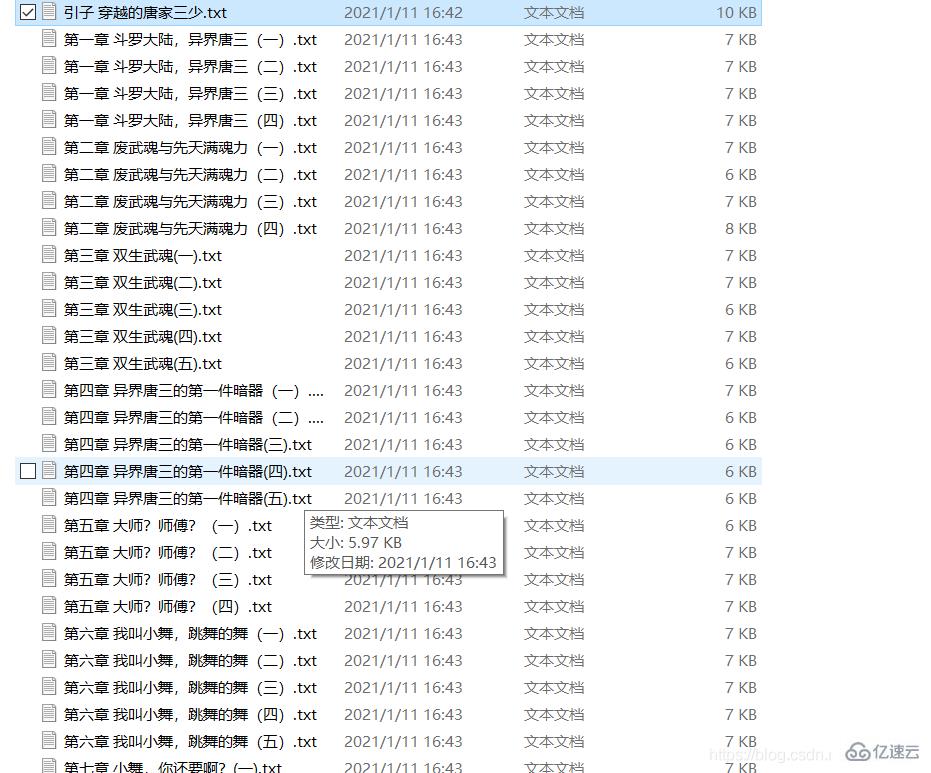
本文只用于学习爬虫
一、网页解析
这里以斗罗大陆小说为例 网址:
http://www.biquge001.com/Book/2/2486/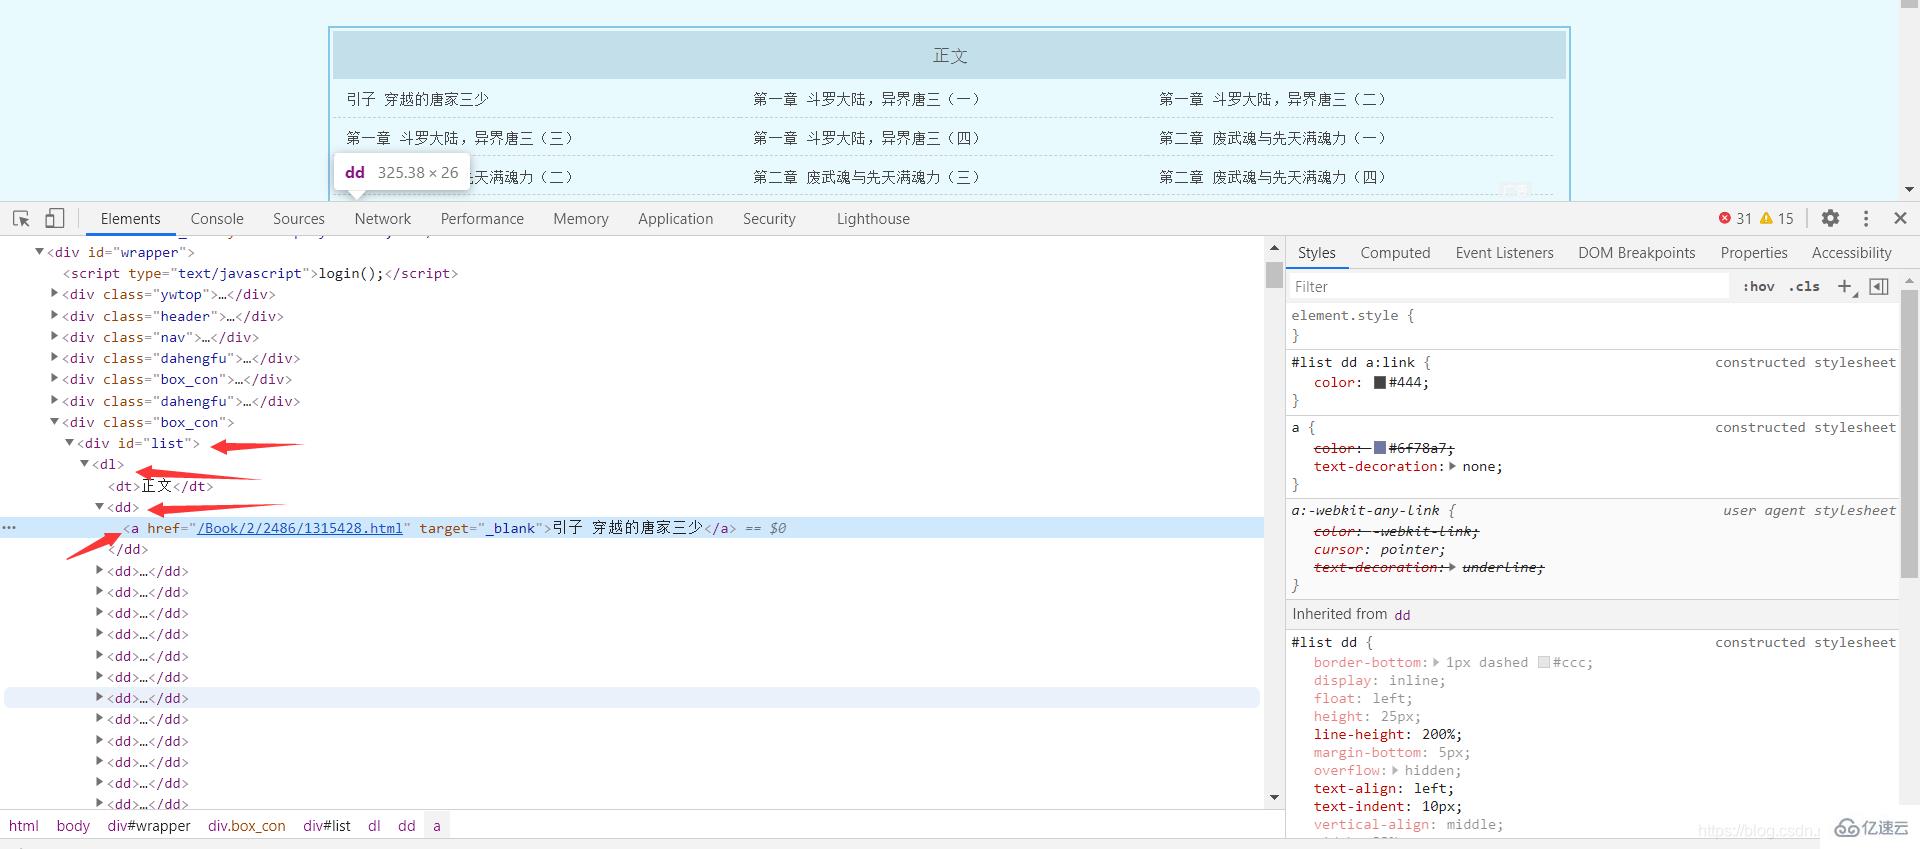
可以发现每章的网页地址和章节名都放在了 <"p id=list dl dd a>中的a标签中,所以利用BeautfulSoup中的select方法可以得到网址和章节名
Tag = BeautifulSoup(getHtmlText(url), "html.parser") #这里的getHtmlText是自己写的获取html的方法urls = Tag.select("p #list dl dd a")然后遍历列表
for url in urls:
    href = "http://www.biquge001.com/" + url['href']  # 字符串的拼接 拼接成正确的网址
    pageName = url.text  # 每章的章名
然后每章小说的内容都存放在
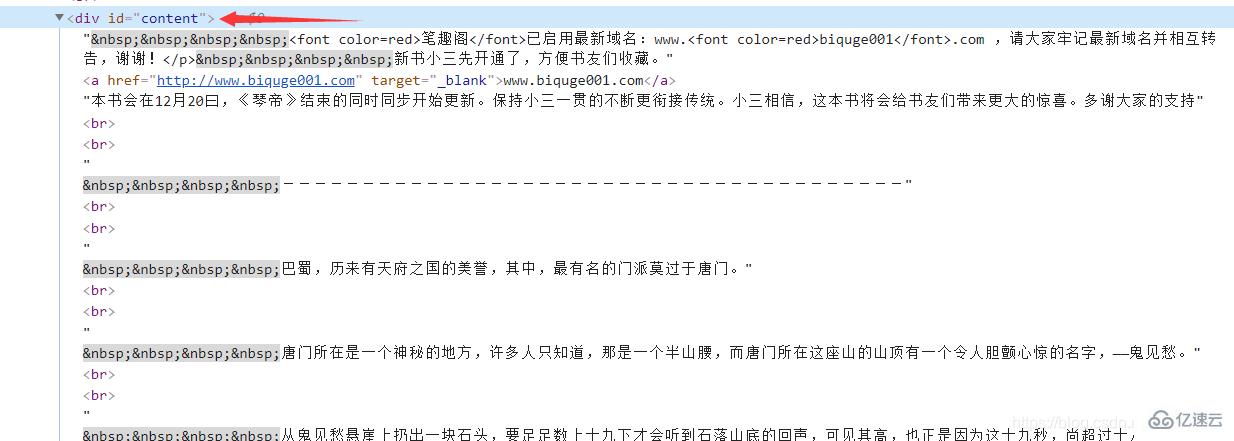
substance = Tag.select("p #content") # 文章的内容最后同理在首页获取小说的名称
<"p id = info h2>
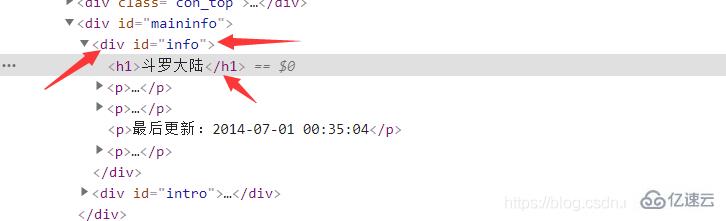
bookName = Tag.select("p #info h2")二、代码填写
1.获取Html及写入方法
def getHtmlText(url):
    r = requests.get(url, headers=headers)
    r.encoding = r.apparent_encoding  # 编码转换
    r.raise_for_status()
    return r.textdef writeIntoTxt(filename, content):
    with open(filename, "w", encoding="utf-8") as f:
        f.write(content)
        f.close()
        print(filename + "已完成")
2.其余代码
代码如下(示例):
url = "http://www.biquge001.com/Book/2/2486/"substanceStr = ""bookName1 = ""html = getHtmlText(url)# 判断是否存在这个文件Tag = BeautifulSoup(getHtmlText(url), "html.parser")urls = Tag.select("p #list dl dd a")bookName = Tag.select("p #info h2")for i in bookName:
    bookName1 = i.textif not os.path.exists(bookName1):
    os.mkdir(bookName1)
    print(bookName1 + "创建完成")else:
    print("文件已创建")for url in urls:
    href = "http://www.biquge001.com/" + url['href']  # 字符串的拼接 拼接成正确的网址
    pageName = url.text  # 每章的章名
    path = bookName1 + "\\"  # 路径
    fileName = path + url.text + ".txt"  # 文件名 = 路径 + 章节名 + ".txt"
    Tag = BeautifulSoup(getHtmlText(href), "html.parser")  # 解析每张的网页
    substance = Tag.select("p #content")  # 文章的内容
    for i in substance:
        substanceStr = i.text
    writeIntoTxt(fileName, substanceStr)
    time.sleep(1)
上一篇:如何建立新的css规则
下一篇:小程序中生成小程序码的方法
相关内容
热门资讯
空调连续工作多久需要停机休息
空调连续工作的时间取决于多个因素,包括空调的型号、功率、使用环境和维护情况等。一般来说,空调可以连续...
空调哪个符号是除湿的
空调除湿功能通常用一个水滴形状的符号表示。不同品牌和型号的空调遥控器可能会有所差异,但一般来说,除湿...
格力空调多长时间加一次氟利昂
1、一般情况下,空调对氟利昂的使用量是非常小的,所以在空调使用了四年左右的时候再考虑加也没问题。2、...
空调用多长时间需要加氟一次
一般情况下是五年。当出现以下这几种情况时,空调才需要加氟。1、空调的室内机和室外机各有两个接口,当接...
格调生活·C标思享荟:卡萨帝在...
9月12日的郑州龙湖金融岛,夜风轻拂,灯光璀璨。“C标时刻共传奇——卡萨帝思享荟暨20周年品牌盛典郑...
品牌价值破千亿、高端份额持续领...
9月12日,“C标时刻共传奇——卡萨帝思享荟暨20周年品牌盛典郑州站”在郑州龙湖金融岛举办。2026...
空调主板坏了修800还是换新的
空调主板坏了是修还是换新,需要考虑多个因素,以下是一些建议:1. 维修成本:如果维修费用较低,比如 ...
空调开多久需要休息多长时间
问题:空调开多久需要休息多长时间回答:1、在使用空调的过程中,一般空调开7~8个小时左右需要休息2~...
中央空调多长时间清洗一次
1、一般空调开机前清洗一次即可,空调开机中间时段再清洗一次,空调关机时清洗一次,这样比较合理。2、空...
中央空调氟利昂多久加一次
看空调制热和制冷程度,很多人的观点认为氟利昂必须一年放一次,其实这个观点是错误的,理解上面有点偏差,...