

使用pyspark怎么对Mysql数据库进行读写操作
pyspark是Spark对Python的api接口,可以在Python环境中通过调用pyspark模块来操作spark,完成大数据框架下的数据分析与挖掘。其中,数据的读写是基础操作,pyspark的子模块pyspark.sql 可以完成大部分类型的数据读写。文本介绍在pyspark中读写Mysql数据库。
1 软件版本
在Python中使用Spark,需要安装配置Spark,这里跳过配置的过程,给出运行环境和相关程序版本信息。
win10 64bit
java 13.0.1
spark 3.0
python 3.8
pyspark 3.0
pycharm 2019.3.4
2 环境配置
pyspark连接Mysql是通过java实现的,所以需要下载连接Mysql的jar包。
下载地址
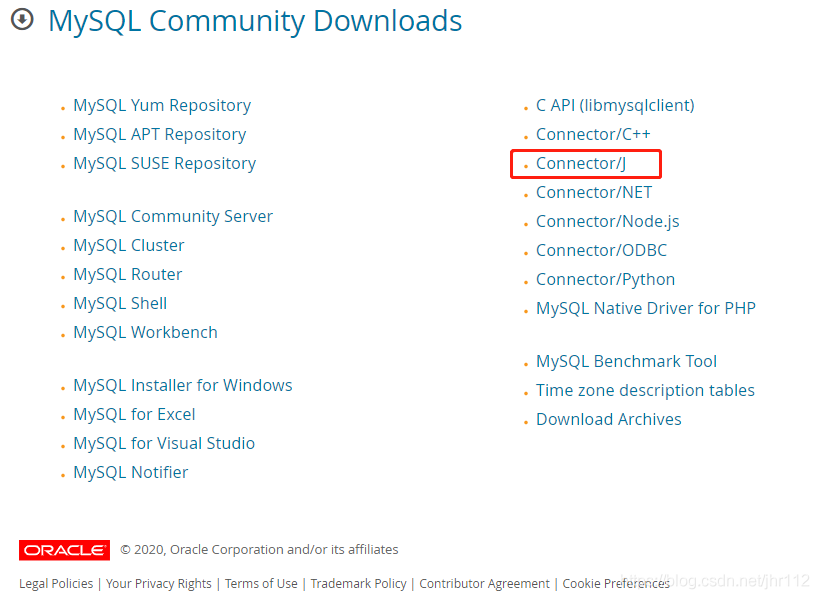
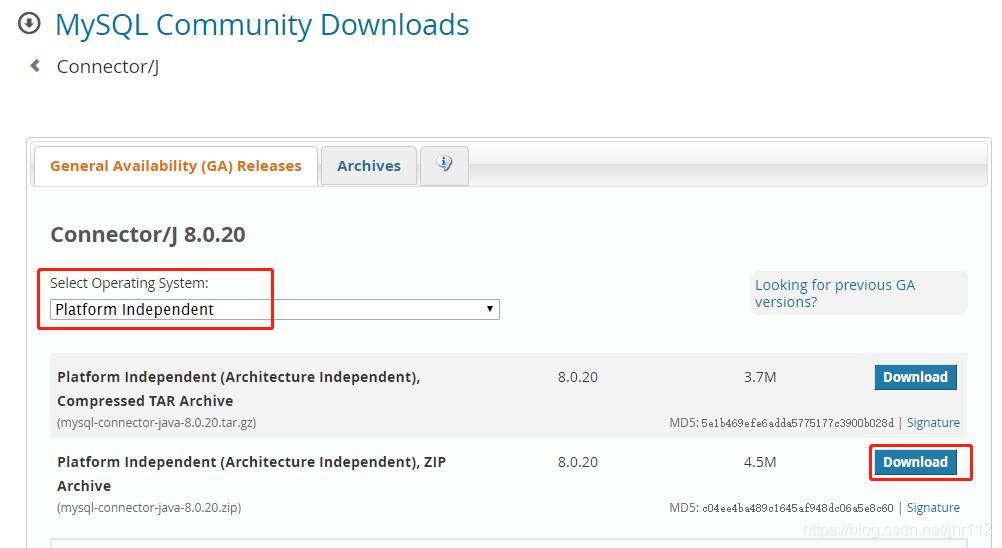
选择下载Connector/J,然后选择操作系统为Platform Independent,下载压缩包到本地。
然后解压文件,将其中的jar包mysql-connector-java-8.0.19.jar放入spark的安装目录下,例如D:\spark\spark-3.0.0-preview2-bin-hadoop2.7\jars。
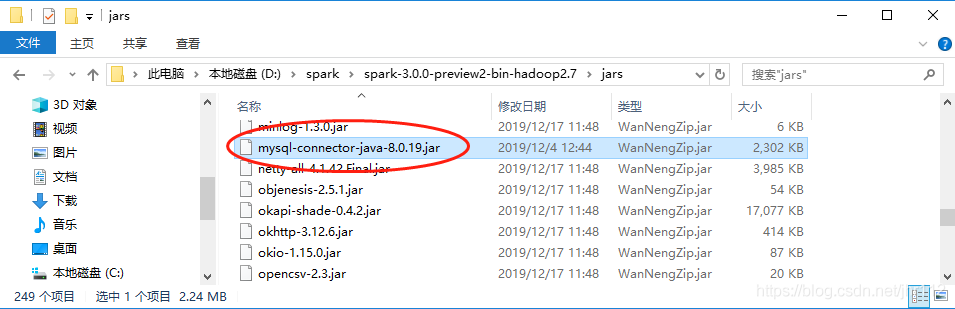
环境配置完成!
3 读取Mysql
脚本如下:
from pyspark.sql import SQLContext, SparkSession

if __name__ == '__main__':
  # spark 初始化
  spark = SparkSession. \
    Builder(). \
    appName('sql'). \
    master('local'). \
    getOrCreate()
  # mysql 配置(需要修改)
  prop = {'user': 'xxx',
      'password': 'xxx',
      'driver': 'com.mysql.cj.jdbc.Driver'}
  # database 地址(需要修改)
  url = 'jdbc:mysql://host:port/database'
  # 读取表
  data = spark.read.jdbc(url=url, table='tb_newCity', properties=prop)
  # 打印data数据类型
  print(type(data))
  # 展示数据
  data.show()
  # 关闭spark会话
  spark.stop()
注意点:
prop参数需要根据实际情况修改,文中用户名和密码用xxx代替了,driver参数也可以不需要;url参数需要根据实际情况修改,格式为jdbc:mysql://主机:端口/数据库;通过调用方法
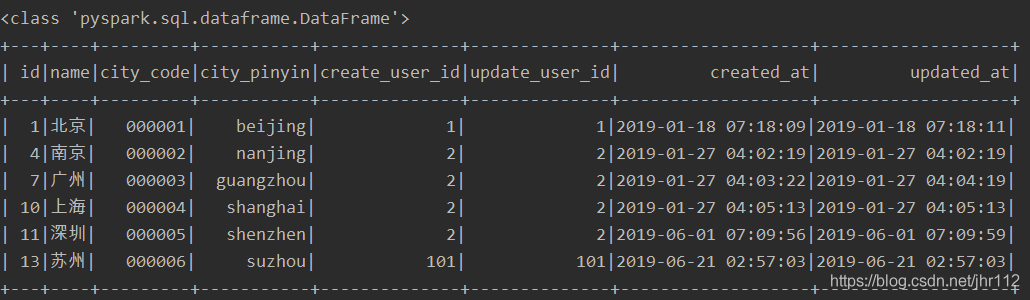
read.jdbc进行读取,返回的数据类型为spark DataFrame;
运行脚本,输出如下:
4 写入Mysql
脚本如下:
import pandas as pd
from pyspark import SparkContext
from pyspark.sql import SQLContext, Row

if __name__ == '__main__':
  # spark 初始化
  sc = SparkContext(master='local', appName='sql')
  spark = SQLContext(sc)
  # mysql 配置(需要修改)
  prop = {'user': 'xxx',
      'password': 'xxx',
      'driver': 'com.mysql.cj.jdbc.Driver'}
  # database 地址(需要修改)
  url = 'jdbc:mysql://host:port/database'

  # 创建spark DataFrame
  # 方式1:list转spark DataFrame
  l = [(1, 12), (2, 22)]
  # 创建并指定列名
  list_df = spark.createDataFrame(l, schema=['id', 'value'])

  # 方式2:rdd转spark DataFrame
  rdd = sc.parallelize(l) # rdd
  col_names = Row('id', 'value') # 列名
  tmp = rdd.map(lambda x: col_names(*x)) # 设置列名
  rdd_df = spark.createDataFrame(tmp)

  # 方式3:pandas dataFrame 转spark DataFrame
  df = pd.DataFrame({'id': [1, 2], 'value': [12, 22]})
  pd_df = spark.createDataFrame(df)

  # 写入数据库
  pd_df.write.jdbc(url=url, table='new', mode='append', properties=prop)
  # 关闭spark会话
  sc.stop()
注意点:
prop和url参数同样需要根据实际情况修改;
写入数据库要求的对象类型是spark DataFrame,提供了三种常见数据类型转spark DataFrame的方法;
通过调用write.jdbc方法进行写入,其中的model参数控制写入数据的行为。
| model | 参数解释 |
|---|---|
| error | 默认值,原表存在则报错 |
| ignore | 原表存在,不报错且不写入数据 |
| append | 新数据在原表行末追加 |
| overwrite | 覆盖原表 |
5 常见报错
Access denied for user …
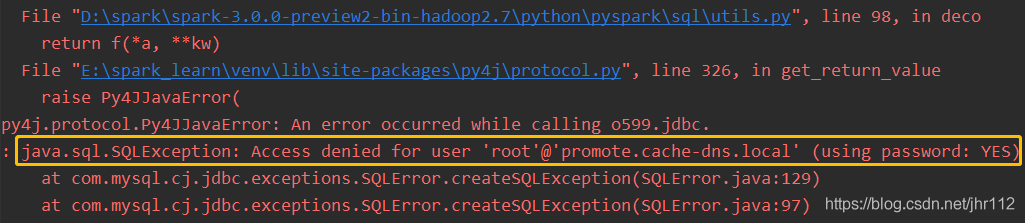
原因:mysql配置参数出错
解决办法:检查user,password拼写,检查账号密码是否正确,用其他工具测试mysql是否能正常连接,做对比检查。
No suitable driver
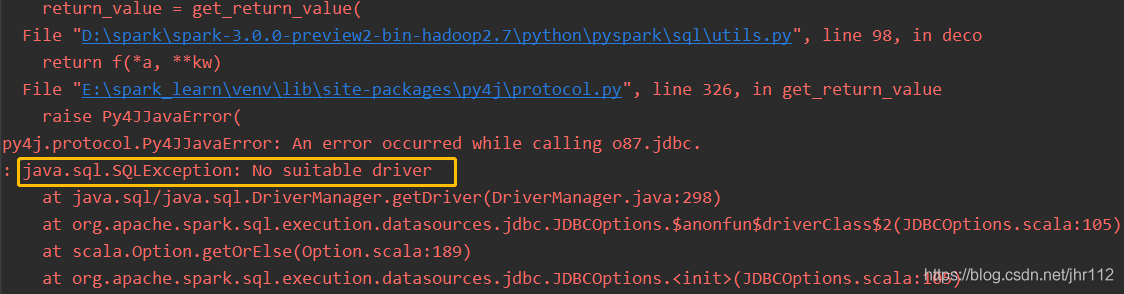
原因:没有配置运行环境
解决办法:下载jar包进行配置,具体过程参考本文的2 环境配置。
下一篇:使用C语言实现一个三子棋小游戏