

php如何实现爬取和分析知乎用户数据
移动端分析数据截图
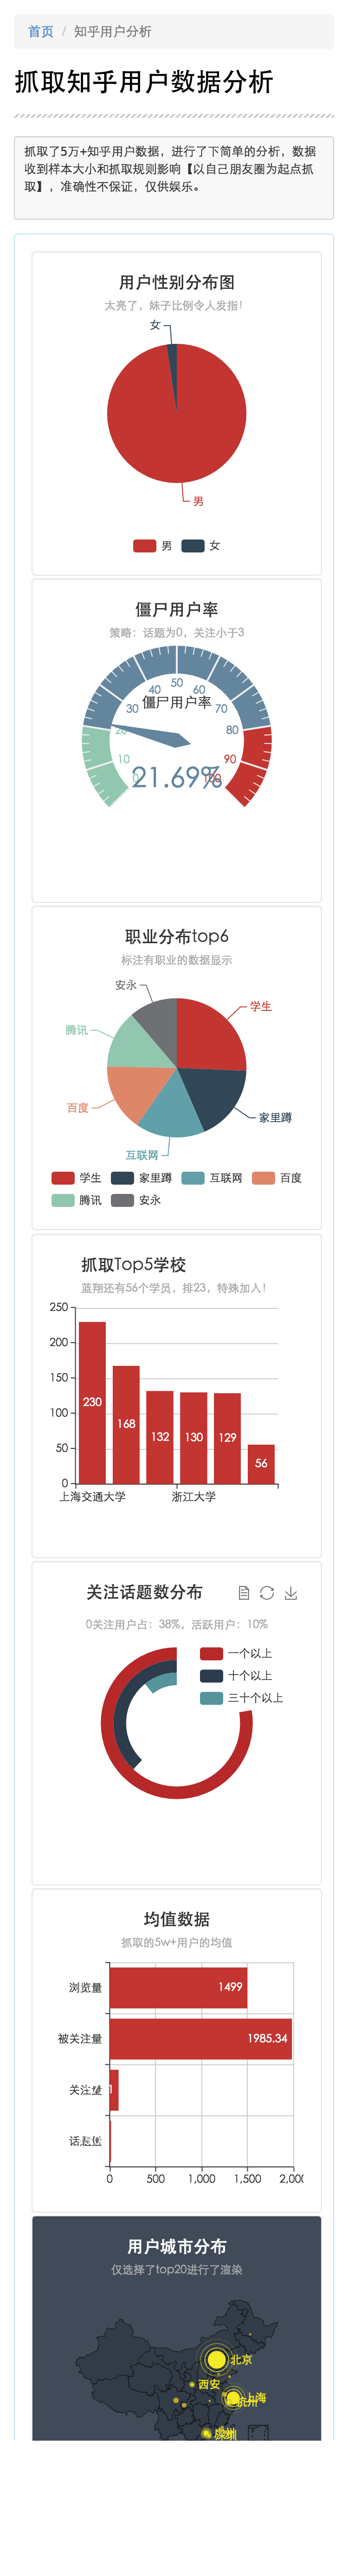
pc端分析数据截图
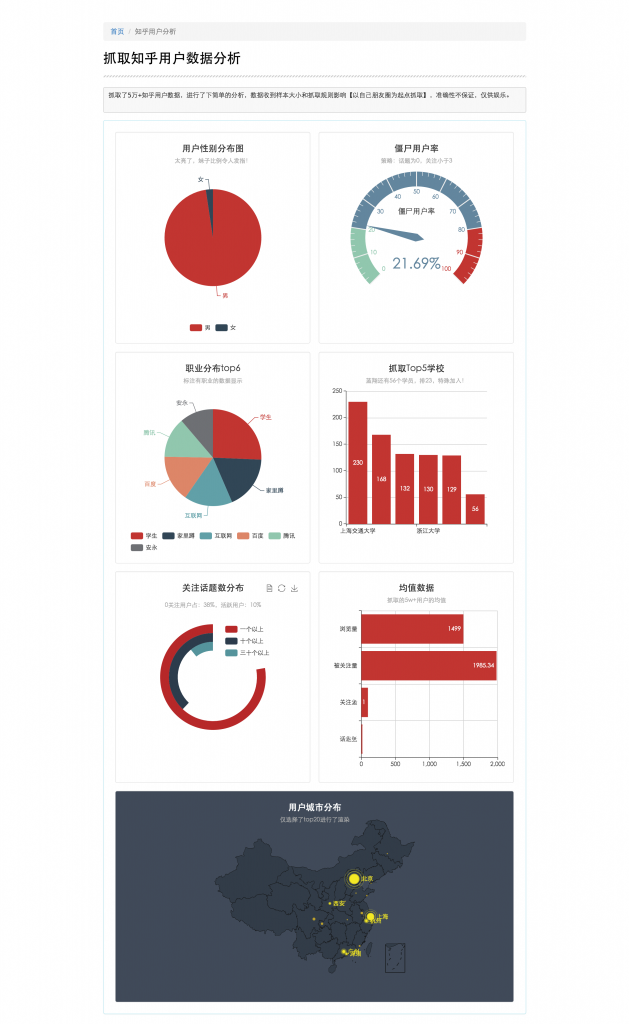
整个爬取,分析,展现过程大概分如下几步,小拽将分别介绍
curl爬取知乎网页数据
正则分析知乎网页数据
数据数据入库和程序部署
数据分析和呈现
curl爬取网页数据
PHP的curl扩展是PHP支持的,允许你与各种服务器使用各种类型的协议进行连接和通信的库。是一个非常便捷的抓取网页的工具,同时,支持多线程扩展。
本程序抓取的是知乎对外提供用户访问的个人信息页面https://www.zhihu.com/people/xxx,抓取过程需要携带用户cookie才能获取页面。直接上码
获取页面cookie
复制代码 代码如下:
// 登录知乎,打开个人中心,打开控制台,获取cookie
document.cookie
"_za=67254197-3wwb8d-43f6-94f0-fb0e2d521c31; _ga=GA1.2.2142818188.1433767929; q_c1=78ee1604225d47d08cddd8142a08288b23|1452172601000|1452172601000; _xsrf=15f0639cbe6fb607560c075269064393; cap_id="N2QwMTExNGQ0YTY2NGVddlMGIyNmQ4NjdjOTU0YTM5MmQ=|1453444256|49fdc6b43dc51f702b7d6575451e228f56cdaf5d"; __utmt=1; unlock_ticket="QUJDTWpmM0lsZdd2dYQUFBQVlRSlZUVTNVb1ZaNDVoQXJlblVmWGJ0WGwyaHlDdVdscXdZU1VRPT0=|1453444421|c47a2afde1ff334d416bafb1cc267b41014c9d5f"; __utma=51854390.21428dd18188.1433767929.1453187421.1453444257.3; __utmb=51854390.14.8.1453444425011; __utmc=51854390; __utmz=51854390.1452846679.1.dd1.utmcsr=google|utmccn=(organic)|utmcmd=organic|utmctr=(not%20provided); __utmv=51854390.100-1|2=registration_date=20150823=1^dd3=entry_date=20150823=1"
抓取个人中心页面
通过curl,携带cookie,先抓取本人中心页面
/**
 * 通过用户名抓取个人中心页面并存储
 *
 * @param $username str :用户名 flag
 * @return boolean   :成功与否标志
 */
public function spiderUser($username)
{
  $cookie = "xxxx" ;
  $url_info = 'http://www.zhihu.com/people/' . $username; //此处cui-xiao-zhuai代表用户ID,可以直接看url获取本人id
  $ch = curl_init($url_info); //初始化会话
  curl_setopt($ch, CURLOPT_HEADER, 0);
  curl_setopt($ch, CURLOPT_COOKIE, $cookie); //设置请求COOKIE
  curl_setopt($ch, CURLOPT_USERAGENT, $_SERVER['HTTP_USER_AGENT']);
  curl_setopt($ch, CURLOPT_RETURNTRANSFER, 1); //将curl_exec()获取的信息以文件流的形式返回,而不是直接输出。
  curl_setopt($ch, CURLOPT_FOLLOWLOCATION, 1);
  $result = curl_exec($ch);

   file_put_contents('/home/work/zxdata_ch/php/zhihu_spider/file/'.$username.'.html',$result);
   return true;
 }
正则分析网页数据分析新链接,进一步爬取
对于抓取过来的网页进行存储,要想进行进一步的爬取,页面必须包含有可用于进一步爬取用户的链接。通过对知乎页面分析发现:在个人中心页面中有关注人和部分点赞人和被关注人。
如下所示
复制代码 代码如下:
ok,这样子就可以通过自己-》关注人-》关注人的关注人-》。。。进行不断爬取。接下来就是通过正则匹配提取该信息
复制代码 代码如下:
// 匹配到抓取页面的所有用户
preg_match_all('/\/people\/([\w-]+)\"/i', $str, $match_arr);
// 去重合并入新的用户数组,用户进一步抓取
self::$newUserArr = array_unique(array_merge($match_arr[1], self::$newUserArr));
到此,整个爬虫过程就可以顺利进行了。
如果需要大量的抓取数据,可以研究下curl_multi和pcntl进行多线程的快速抓取,此处不做赘述。
分析用户数据,提供分析
通过正则可以进一步匹配出更多的该用户数据,直接上码。
// 获取用户头像
preg_match('//i', $str, $match_img);
$img_url = $match_img[1];
// 匹配用户名:
// 崔小拽
preg_match('/([\x{4e00}-\x{9fa5}]+).+span>/u', $str, $match_name);
$user_name = $match_name[1];
// 匹配用户简介
// class bio span 中文
preg_match('/([\x{4e00}-\x{9fa5}]+).+span>/u', $str, $match_title);
$user_title = $match_title[1];
// 匹配性别
//
preg_match('//u', $str, $match_city);
$user_city = $match_city[1];
// 匹配工作
//人见人骂的公司
preg_match('//u', $str, $match_employment);
$user_employ = $match_employment[1];
// 匹配职位
// 程序猿
preg_match('//u', $str, $match_position);
$user_position = $match_position[1];
// 匹配学历
// 研究僧
preg_match('//u', $str, $match_education);
$user_education = $match_education[1];
// 工作情况
// 挨踢
preg_match('/([\x{4e00}-
\x{9fa5}]+)41 个话题
preg_match('/class=\"?zg-link-litblue\"?>(\d+)\s.+strong>/i', $str, $match_topic);
$user_topic = $match_topic[1];
// 关注人数
// 关注了
preg_match_all('/(\d+)<.+ 在抓取的过程中,有条件的话,一定要通过redis入库,确实能提升抓取和入库效率。没有条件的话只能通过sql优化。这里来几发心德。
数据库表设计索引一定要慎重。在spider爬取的过程中,建议出了用户名,左右字段都不要索引,包括主键都不要,尽可能的提高入库效率,试想5000w的数据,每次添加一个,建立索引需要多少消耗。等抓取完毕,需要分析数据时,批量建立索引。
数据入库和更新操作,一定要批量。 mysql 官方给出的增删改的建议和速度:http://dev.mysql.com/doc/refman/5.7/en/insert-speed.html
# 官方的最优批量插入
INSERT INTO yourtable VALUES (1,2), (5,5), ...;
部署操作。程序在抓取过程中,有可能会出现异常挂掉,为了保证高效稳定,尽可能的写一个定时脚本。每隔一段时间干掉,重新跑,这样即使异常挂掉也不会浪费太多宝贵时间,毕竟,time is money。
#!/bin/bash

# 干掉
ps aux |grep spider |awk '{print $2}'|xargs kill -9
sleep 5s

# 重新跑
nohup /home/cuixiaohuan/lamp/php5/bin/php /home/cuixiaohuan/php/zhihu_spider/spider_new.php &
数据分析呈现
数据的呈现主要使用echarts 3.0,感觉对于移动端兼容还不错。兼容移动端的页面响应式布局主要通过几个简单的css控制,代码如下
// 获取用户头像
preg_match('//i', $str, $match_img);
$img_url = $match_img[1];
// 匹配用户名:
// 崔小拽
preg_match('/([\x{4e00}-\x{9fa5}]+).+span>/u', $str, $match_name);
$user_name = $match_name[1];
// 匹配用户简介
// class bio span 中文
preg_match('/([\x{4e00}-\x{9fa5}]+).+span>/u', $str, $match_title);
$user_title = $match_title[1];
// 匹配性别
//
preg_match('//u', $str, $match_city);
$user_city = $match_city[1];
// 匹配工作
//人见人骂的公司
preg_match('//u', $str, $match_employment);
$user_employ = $match_employment[1];
// 匹配职位
// 程序猿
preg_match('//u', $str, $match_position);
$user_position = $match_position[1];
// 匹配学历
// 研究僧
preg_match('//u', $str, $match_education);
$user_education = $match_education[1];
// 工作情况
// 挨踢
preg_match('/([\x{4e00}-
\x{9fa5}]+)41 个话题
preg_match('/class=\"?zg-link-litblue\"?>(\d+)\s.+strong>/i', $str, $match_topic);
$user_topic = $match_topic[1];
// 关注人数
// 关注了
preg_match_all('/(\d+)<.+