

利用Python爬虫怎么爬取喜马拉雅app上的音频数据
创始人
2024-11-21 15:40:37
0次
环境:
1.确定数据所在的链接地址(url)
2.通过代码发送url地址的请求
3.解析数据(要的, 筛选不要的)
4.数据持久化(保存)
案例思路:
1. 在静态数据中获取音频的id值
2. 发送指定id值json数据请求(src)
3. 从json数据中解析音频所对应的URL地址 开始写代码
先导入所需的模块
import requests
import parsel # 数据解析模块
import re
1.确定数据所在的链接地址(url) 逆向分析 网页性质(静态网页/动态网页)
打开开发者工具,播放一个音频,在Madie里面可以找到一个数据包
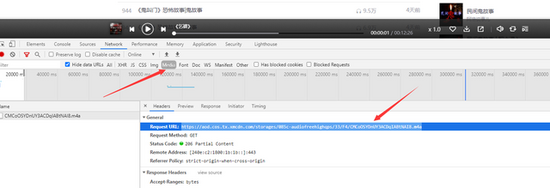
复制URL,搜索
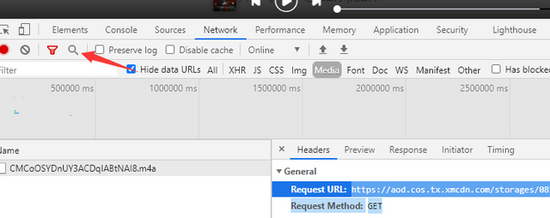
找到ID值
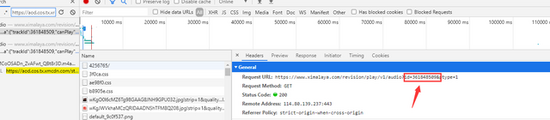
继续搜索,找到请求头参数
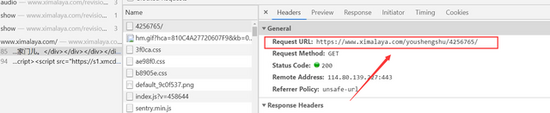
url = 'https://www.ximalaya.com/youshengshu/4256765/p{}/'.format(page)
headers = {
 'user-agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/84.0.4147.105 Safari/537.36'}
2.通过代码发送url地址的请求
response = requests.get(url=url, headers=headers)
html_data = response.text
3.解析数据(要的, 筛选不要的) 解析音频的 id值
selector = parsel.Selector(html_data)
lis = selector.xpath('//div[@class="sound-list _is"]/ul/li')

for li in lis:
 try:
  title = li.xpath('.//a/@title').get() + '.m4a'
  href = li.xpath('.//a/@href').get()
  # print(title, href)

  m4a_id = href.split('/')[-1]
  # print(href, m4a_id)

  # 发送指定id值json数据请求(src)
  json_url = 'https://www.ximalaya.com/revision/play/v1/audio?id={}&ptype=1'.format(m4a_id)
  json_data = requests.get(url=json_url, headers=headers).json()
  # print(json_data)

  # 提取音频地址
  m4a_url = json_data['data']['src']
  # print(m4a_url)

  # 请求音频数据
  m4a_data = requests.get(url=m4a_url, headers=headers).content

  new_title = change_title(title)
4.数据持久化(保存)
with open('video\\' + new_title, mode='wb') as f:
 f.write(m4a_data)
 print('保存完成:', title)
最后还要处理文件名非法字符
def change_title(title):
 pattern = re.compile(r"[\/\\\:\*\?\"\<\>\|]") # '/ \ : * ? " < > |'
 new_title = re.sub(pattern, "_", title) # 替换为下划线
 return new_title
完整代码
import re

import requests
import parsel # 数据解析模块


def change_title(title):
 """处理文件名非法字符的方法"""
 pattern = re.compile(r"[\/\\\:\*\?\"\<\>\|]") # '/ \ : * ? " < > |'
 new_title = re.sub(pattern, "_", title) # 替换为下划线
 return new_title


for page in range(13, 33):
 print('---------------正在爬取第{}页的数据----------------'.format(page))
 # 1.确定数据所在的链接地址(url) 逆向分析 网页性质(静态网页/动态网页)
 url = 'https://www.ximalaya.com/youshengshu/4256765/p{}/'.format(page)
 headers = {
  'user-agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/84.0.4147.105 Safari/537.36'}

 # 2.通过代码发送url地址的请求
 response = requests.get(url=url, headers=headers)
 html_data = response.text
 # print(html_data)

 # 3.解析数据(要的, 筛选不要的) 解析音频的 id值
 selector = parsel.Selector(html_data)
 lis = selector.xpath('//div[@class="sound-list _is"]/ul/li')

 for li in lis:
  try:
   title = li.xpath('.//a/@title').get() + '.m4a'
   href = li.xpath('.//a/@href').get()
   # print(title, href)

   m4a_id = href.split('/')[-1]
   # print(href, m4a_id)

   # 发送指定id值json数据请求(src)
   json_url = 'https://www.ximalaya.com/revision/play/v1/audio?id={}&ptype=1'.format(m4a_id)
   json_data = requests.get(url=json_url, headers=headers).json()
   # print(json_data)

   # 提取音频地址
   m4a_url = json_data['data']['src']
   # print(m4a_url)

   # 请求音频数据
   m4a_data = requests.get(url=m4a_url, headers=headers).content

   new_title = change_title(title)
   # print(new_title)

   # 4.数据持久化(保存)
   with open('video\\' + new_title, mode='wb') as f:
    f.write(m4a_data)
    print('保存完成:', title)
  except:
   pass
相关内容
热门资讯
空调连续工作多久需要停机休息
空调连续工作的时间取决于多个因素,包括空调的型号、功率、使用环境和维护情况等。一般来说,空调可以连续...
空调哪个符号是除湿的
空调除湿功能通常用一个水滴形状的符号表示。不同品牌和型号的空调遥控器可能会有所差异,但一般来说,除湿...
格力空调多长时间加一次氟利昂
1、一般情况下,空调对氟利昂的使用量是非常小的,所以在空调使用了四年左右的时候再考虑加也没问题。2、...
空调用多长时间需要加氟一次
一般情况下是五年。当出现以下这几种情况时,空调才需要加氟。1、空调的室内机和室外机各有两个接口,当接...
格调生活·C标思享荟:卡萨帝在...
9月12日的郑州龙湖金融岛,夜风轻拂,灯光璀璨。“C标时刻共传奇——卡萨帝思享荟暨20周年品牌盛典郑...
品牌价值破千亿、高端份额持续领...
9月12日,“C标时刻共传奇——卡萨帝思享荟暨20周年品牌盛典郑州站”在郑州龙湖金融岛举办。2026...
空调主板坏了修800还是换新的
空调主板坏了是修还是换新,需要考虑多个因素,以下是一些建议:1. 维修成本:如果维修费用较低,比如 ...
空调开多久需要休息多长时间
问题:空调开多久需要休息多长时间回答:1、在使用空调的过程中,一般空调开7~8个小时左右需要休息2~...
中央空调多长时间清洗一次
1、一般空调开机前清洗一次即可,空调开机中间时段再清洗一次,空调关机时清洗一次,这样比较合理。2、空...
中央空调氟利昂多久加一次
看空调制热和制冷程度,很多人的观点认为氟利昂必须一年放一次,其实这个观点是错误的,理解上面有点偏差,...