

使用python爬虫怎么结合唧唧对Bilibili进行爬取
创始人
2024-11-21 06:22:57
0次
爬虫部分
1.依赖库
requestsl
xml
2.代码
相关讲解已在注释标注。
'''
author:Ericam
description: 用于爬取b站视频链接
'''
import requests
import re
from lxml import etree
import time

'''
该函数用于解析爬取的网页。
提取出网页里视频的url链接以及对应的视频名。
'''
def getHref(url,page):
 try:
 req = requests.get(url,timeout=5,headers=headers)
 html = req.text
 data = etree.HTML(html)
 '''
 page-1://*[@id="all-list"]/div[1]/div[2]/ul[@class="video-list"]/li
 other://*[@id="all-list"]/div[1]/ul[@class="video-list"]/li
 '''
 pattern = '//*[@id="all-list"]/div[1]/div[2]/ul[contains(@class,"video-list")]/li' if page == 1 else '//*[@id="all-list"]/div[1]/ul[contains(@class,"video-list")]/li'
 vurlList = data.xpath(pattern)
 for li in vurlList:
  vurl = li.xpath(".//a/attribute::href")[0]
  title = li.xpath(".//a/attribute::title")[0]
  yield vurl,title
 except:
 print('第%d页爬取失败' % page)
 print('Unfortunitely -- An Unknow Error Happened, Please wait 3 seconds')
 time.sleep(3)

'''
该函数用于正则提取,将url内的BV号提取出来
'''
def getBv(href):
 pattern = re.compile('(BV.*?)\?')
 data = re.search(pattern,href)
 if data == None:
 return ''
 return data.group(1)

if __name__ == "__main__":

 #头部伪装
 headers = {
 'User-Agent':'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.132 Safari/537.36 QIHU 360SE'
 }
 hrefList = []
 titleList = []
 #需要爬取多少页,自行进行修改,本代码测试1~2页
 for i in range(1,3):
 url = "https://search.bilibili.com/all?keyword=歪嘴战神&page={0}".format(i) #修改keyword后的关键字即可
 l = getHref(url,i)
 for vurl,title in l:
  hrefList.append(vurl)
  titleList.append(title)
 print("第{0}页爬取结束".format(i))
 time.sleep(2)

 print("---------------------------开始截取BV号-----------------------------")
 for i in range(len(hrefList)):
 hrefList[i] = getBv(hrefList[i])
 with open("bv.txt",'w',encoding='utf-8') as f:
 for i in range(len(hrefList)):
  f.write(hrefList[i]+"\t"+titleList[i]+"\n")
 print("爬取结束")
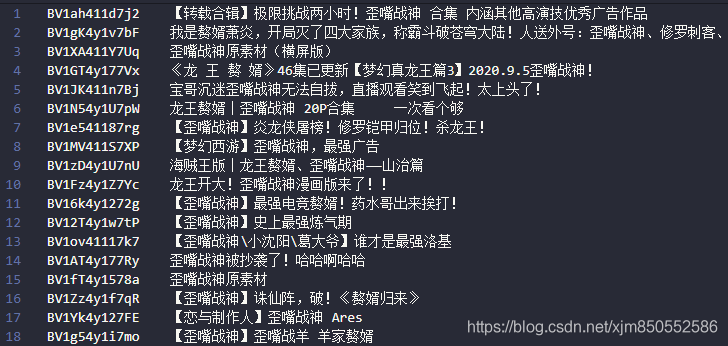
3.爬取结果
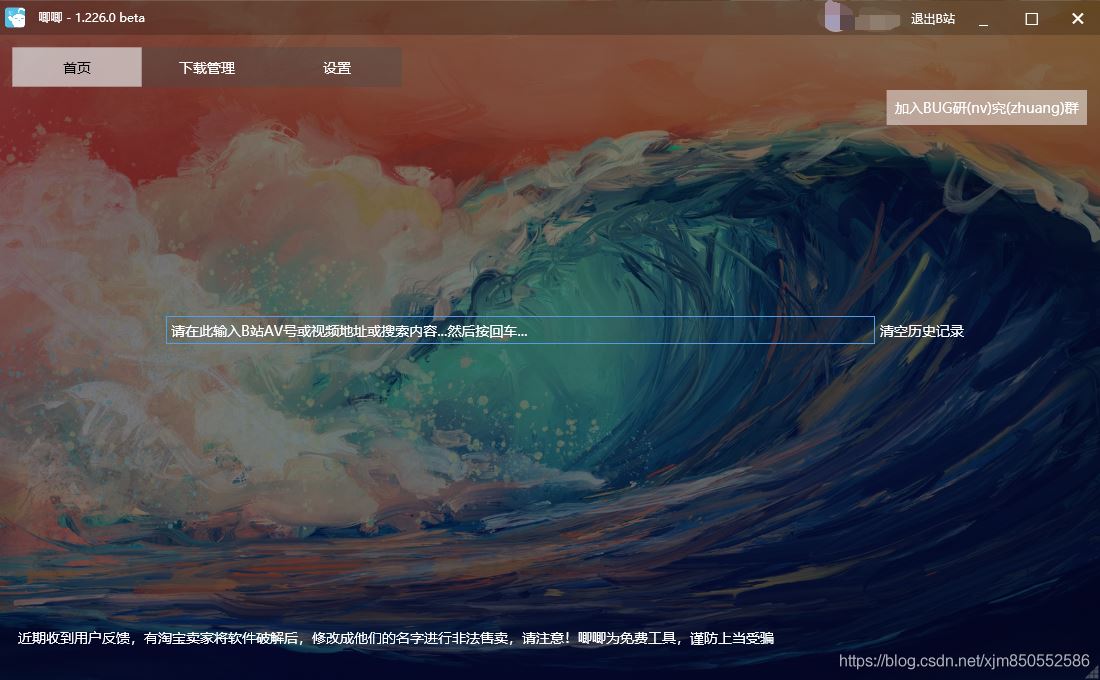
唧唧下载视频
给出唧唧的链接,唧唧,很好用的小工具。
我们只需要将刚才爬取好的链接放在一边,不断复制BV号,然后唧唧进行下载即可。
视频重命名
唧唧下载好的视频如下所示:

为什么需要将它们进行改名呢,因为如果当视频数量越来越多时,比如几千几万时,通过名字便会越来越难以管理,同时也难以进行去重,很大概率会不断下载重复的视频。
在B站,BV号便是每个视频的“身份证”(主键),因此用其进行视频命名可以方便日后管理,同时也方便进行去重。
代码
'''
author:Ericam
description: 用于将下载下来的b站视频重命名,命名格式为bv号
'''
import os
import difflib

if __name__ == '__main__':

 bvpath = os.path.join("D:/","Coding","python","Python爬虫")
 os.chdir(bvpath)
 d = {}
 '''
 bvdownload.txt里存放bv号与title名
 若之前爬虫爬取了几千个,而唧唧只下载了几百个,便可以将这些已下载的bv和title复制到
 bvdownload.txt中,将已下载的视频进行改名
 '''
 with open("bvdownload.txt",'r',encoding='utf-8')as f:
 lines = f.readlines()
 for val in lines:
  val = val.strip("\n")
  data = val.split("\t")
  bv = data[0]
  title = data[1]
  d[title] = bv

 #视频存放位置
 path = 'F:/bilibili视频/'
 os.chdir(path)
 videoList = os.listdir()

 #开始进行模糊匹配
 for key in d:
 video = difflib.get_close_matches(key,videoList,1, cutoff=0.3)
 if len(video) == 0:
  continue
 video = video[0]
 #检查视频是否已存在,若存在则删除视频
 if os.path.isfile(d[key]+".mp4") and os.path.isfile(video):
  os.remove(video)
 else:
  if os.path.isfile(video):
  os.rename(video,d[key]+".mp4")
 print("重命名完成!")
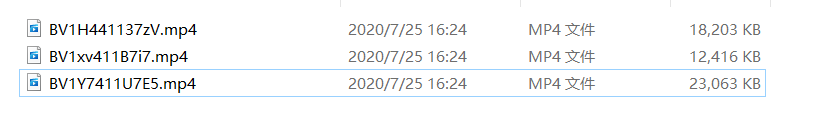
结果演示
重命名完成的视频列表如下:
相关内容
热门资讯
空调连续工作多久需要停机休息
空调连续工作的时间取决于多个因素,包括空调的型号、功率、使用环境和维护情况等。一般来说,空调可以连续...
空调哪个符号是除湿的
空调除湿功能通常用一个水滴形状的符号表示。不同品牌和型号的空调遥控器可能会有所差异,但一般来说,除湿...
格力空调多长时间加一次氟利昂
1、一般情况下,空调对氟利昂的使用量是非常小的,所以在空调使用了四年左右的时候再考虑加也没问题。2、...
空调用多长时间需要加氟一次
一般情况下是五年。当出现以下这几种情况时,空调才需要加氟。1、空调的室内机和室外机各有两个接口,当接...
格调生活·C标思享荟:卡萨帝在...
9月12日的郑州龙湖金融岛,夜风轻拂,灯光璀璨。“C标时刻共传奇——卡萨帝思享荟暨20周年品牌盛典郑...
品牌价值破千亿、高端份额持续领...
9月12日,“C标时刻共传奇——卡萨帝思享荟暨20周年品牌盛典郑州站”在郑州龙湖金融岛举办。2026...
空调主板坏了修800还是换新的
空调主板坏了是修还是换新,需要考虑多个因素,以下是一些建议:1. 维修成本:如果维修费用较低,比如 ...
空调开多久需要休息多长时间
问题:空调开多久需要休息多长时间回答:1、在使用空调的过程中,一般空调开7~8个小时左右需要休息2~...
中央空调多长时间清洗一次
1、一般空调开机前清洗一次即可,空调开机中间时段再清洗一次,空调关机时清洗一次,这样比较合理。2、空...
中央空调氟利昂多久加一次
看空调制热和制冷程度,很多人的观点认为氟利昂必须一年放一次,其实这个观点是错误的,理解上面有点偏差,...