

用python实现一个PDF转换器
创始人
2024-11-17 21:41:53
0次
一、思路分析
网上一搜,你可以发现很多PDF转换的工具,其中不乏在线转换的网站,比如这样的:
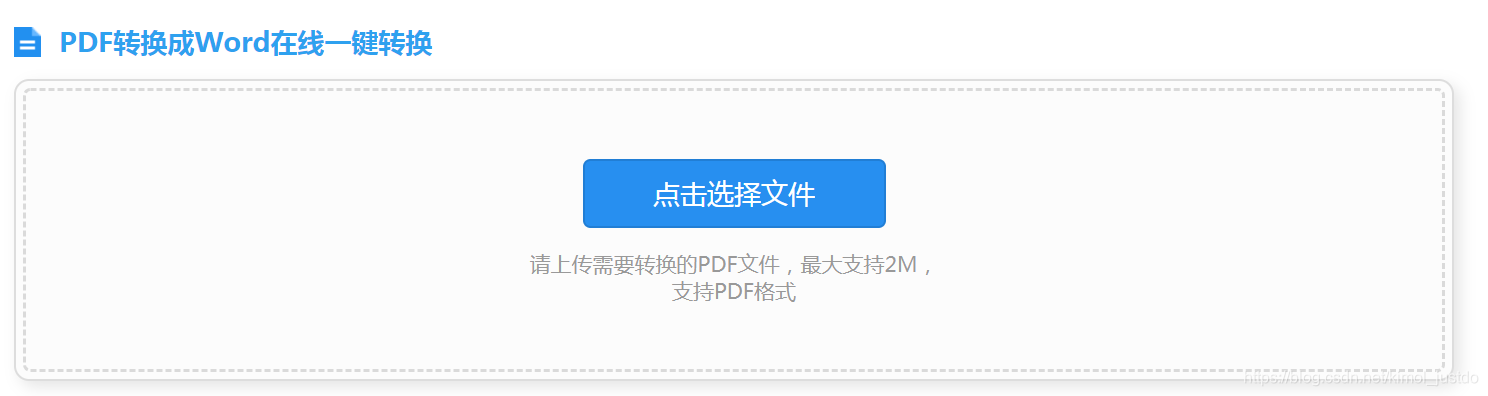
那么,通过网站提供的测试接口,我们便可以通过爬虫模拟的方式实现转换。
没有错了~思路就是如此的简单明了,今天的主角便是:https://app.xunjiepdf.com
通过抓包分析,知道这是一个POST请求,接下来用requests库模拟即可。需要注意的是,这个接口仅用于测试,所以可供转换的页面等都有所限制,如需更完整的功能还请支持原版。
二、我的代码
正所谓一万个coders,就有一万种codes,以下为我的代码,仅供参考。
导入相关库:
import time
import requests
定义PDF2Word类:
class PDF2Word():
 def __init__(self):
  self.machineid = 'ccc052ee5200088b92342303c4ea9399'
  self.token = ''
  self.guid = ''
  self.keytag = ''

 def produceToken(self):
  url = 'https://app.xunjiepdf.com/api/producetoken'
  headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 6.3; Win64; x64; rv:76.0) Gecko/20100101 Firefox/76.0',
    'Accept': 'application/json, text/javascript, */*; q=0.01',
    'Accept-Language': 'zh-CN,zh;q=0.8,zh-TW;q=0.7,zh-HK;q=0.5,en-US;q=0.3,en;q=0.2',
    'Content-Type': 'application/x-www-form-urlencoded; charset=UTF-8',
    'X-Requested-With': 'XMLHttpRequest',
    'Origin': 'https://app.xunjiepdf.com',
    'Connection': 'keep-alive',
    'Referer': 'https://app.xunjiepdf.com/pdf2word/',}
  data = {'machineid':self.machineid}
  res = requests.post(url,headers=headers,data=data)
  res_json = res.json()
  if res_json['code'] == 10000:
   self.token = res_json['token']
   self.guid = res_json['guid']
   print('成功获取token')
   return True
  else:
   return False

 def uploadPDF(self,filepath):
  filename = filepath.split('/')[-1]
  files = {'file': open(filepath,'rb')}
  url = 'https://app.xunjiepdf.com/api/Upload'
  headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 6.3; Win64; x64; rv:76.0) Gecko/20100101 Firefox/76.0',
    'Accept': '*/*',
    'Accept-Language': 'zh-CN,zh;q=0.8,zh-TW;q=0.7,zh-HK;q=0.5,en-US;q=0.3,en;q=0.2',
    'Content-Type': 'application/pdf',
    'Origin': 'https://app.xunjiepdf.com',
    'Connection': 'keep-alive',
    'Referer': 'https://app.xunjiepdf.com/pdf2word/',}
  params = (
    ('tasktype', 'pdf2word'),
    ('phonenumber', ''),
    ('loginkey', ''),
    ('machineid', self.machineid),
    ('token', self.token),
    ('limitsize', '2048'),
    ('pdfname', filename),
    ('queuekey', self.guid),
    ('uploadtime', ''),
    ('filecount', '1'),
    ('fileindex', '1'),
    ('pagerange', 'all'),
    ('picturequality', ''),
    ('outputfileextension', 'docx'),
    ('picturerotate', '0,undefined'),
    ('filesequence', '0,undefined'),
    ('filepwd', ''),
    ('iconsize', ''),
    ('picturetoonepdf', ''),
    ('isshare', '0'),
    ('softname', 'pdfonlineconverter'),
    ('softversion', 'V5.0'),
    ('validpagescount', '20'),
    ('limituse', '1'),
    ('filespwdlist', ''),
    ('fileCountwater', '1'),
    ('languagefrom', ''),
    ('languageto', ''),
    ('cadverchose', ''),
    ('pictureforecolor', ''),
    ('picturebackcolor', ''),
    ('id', 'WU_FILE_1'),
    ('name', filename),
    ('type', 'application/pdf'),
    ('lastModifiedDate', ''),
    ('size', ''),)
  res= requests.post(url,headers=headers,params=params,files=files)
  res_json = res.json()
  if res_json['message'] == '上传成功':
   self.keytag = res_json['keytag']
   print('成功上传PDF')
   return True
  else:
   return False

 def progress(self):
  url = 'https://app.xunjiepdf.com/api/Progress'
  headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 6.3; Win64; x64; rv:76.0) Gecko/20100101 Firefox/76.0',
    'Accept': 'text/plain, */*; q=0.01',
    'Accept-Language': 'zh-CN,zh;q=0.8,zh-TW;q=0.7,zh-HK;q=0.5,en-US;q=0.3,en;q=0.2',
    'Content-Type': 'application/x-www-form-urlencoded; charset=UTF-8',
    'X-Requested-With': 'XMLHttpRequest',
    'Origin': 'https://app.xunjiepdf.com',
    'Connection': 'keep-alive',
    'Referer': 'https://app.xunjiepdf.com/pdf2word/',}
  data = {
    'tasktag': self.keytag,
    'phonenumber': '',
    'loginkey': '',
    'limituse': '1'}
  res= requests.post(url,headers=headers,data=data)
  res_json = res.json()
  if res_json['message'] == '处理成功':
   print('PDF处理完成')
   return True
  else:
   print('PDF处理中')
   return False

 def downloadWord(self,output):
  url = 'https://app.xunjiepdf.com/download/fileid/%s'%self.keytag
  res = requests.get(url)
  with open(output,'wb') as f:
   f.write(res.content)
   print('PDF下载成功("%s")'%output)

 def convertPDF(self,filepath,outpath):
  filename = filepath.split('/')[-1]
  filename = filename.split('.')[0]+'.docx'
  self.produceToken()
  self.uploadPDF(filepath)
  while True:
   res = self.progress()
   if res == True:
    break
   time.sleep(1)
  self.downloadWord(outpath+filename)
执行主函数:
if __name__=='__main__':
 pdf2word = PDF2Word()
 pdf2word.convertPDF('001.pdf','')
注意:convertPDF函数有两个参数,第一个为需要转换的PDF,第二个参数为转换后的目录。
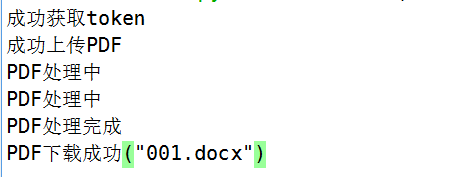
run一下,一键入魂,".docx"文件已经躺在了我的目录中,舒服了~
下一篇:使用TS编写express服务器
相关内容
热门资讯
空调连续工作多久需要停机休息
空调连续工作的时间取决于多个因素,包括空调的型号、功率、使用环境和维护情况等。一般来说,空调可以连续...
空调哪个符号是除湿的
空调除湿功能通常用一个水滴形状的符号表示。不同品牌和型号的空调遥控器可能会有所差异,但一般来说,除湿...
格力空调多长时间加一次氟利昂
1、一般情况下,空调对氟利昂的使用量是非常小的,所以在空调使用了四年左右的时候再考虑加也没问题。2、...
空调用多长时间需要加氟一次
一般情况下是五年。当出现以下这几种情况时,空调才需要加氟。1、空调的室内机和室外机各有两个接口,当接...
格调生活·C标思享荟:卡萨帝在...
9月12日的郑州龙湖金融岛,夜风轻拂,灯光璀璨。“C标时刻共传奇——卡萨帝思享荟暨20周年品牌盛典郑...
品牌价值破千亿、高端份额持续领...
9月12日,“C标时刻共传奇——卡萨帝思享荟暨20周年品牌盛典郑州站”在郑州龙湖金融岛举办。2026...
空调主板坏了修800还是换新的
空调主板坏了是修还是换新,需要考虑多个因素,以下是一些建议:1. 维修成本:如果维修费用较低,比如 ...
空调开多久需要休息多长时间
问题:空调开多久需要休息多长时间回答:1、在使用空调的过程中,一般空调开7~8个小时左右需要休息2~...
中央空调多长时间清洗一次
1、一般空调开机前清洗一次即可,空调开机中间时段再清洗一次,空调关机时清洗一次,这样比较合理。2、空...
中央空调氟利昂多久加一次
看空调制热和制冷程度,很多人的观点认为氟利昂必须一年放一次,其实这个观点是错误的,理解上面有点偏差,...