

R语言实现固定分组汇总的方法
组名称和组数量已知的分组汇总被称为固定分组汇总,此类算法的分组依据来自于数据集之外,比如:按照参数列表中的客户名单分组,或按照条件列表进行分组。此类算法会涉及分组依据是否超出数据集、是否需要多余的组、数据是否重叠等问题,解决起来有一定的难度。本文将介绍R语言实现固定分组汇总的方法。
例1:分组依据不超出数据集
数据框sales是订单记录,其中CLIENT列是客户名,AMOUNT列是订单金额,请将sales按照“潜力客户列表”进行分组,并对各组的AMOUNT列汇总求和。潜力客户列表为[ARO,BON,CHO],该列表恰好是CLIENT列的子集。
说明:sales的来源可以是数据库也可以是文件,比如:orders<-read.table("sales.txt",sep="\t", header=TRUE)。其前几行数据如下:
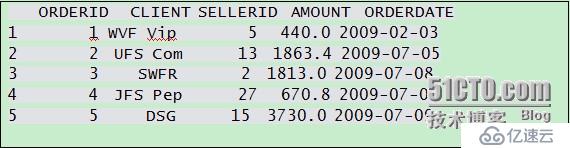
代码:
byFac<-factor(sales$CLIENT,levels=c("ARO","BON","CHO"))
result<-aggregate(sales$AMOUNT,list(byFac),sum)
计算结果:
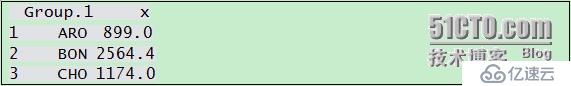
代码解读:
1.函数factor生成了一个分组依据(在R中被称为因子),函数aggregate按照分组依据进行分组汇总,整段代码的结构非常清晰。
2.需要注意的是,分组依据不是向量或数组,因此不能直接写成byFac<- c("ARO","BON","CHO")。分组依据也不能直接使用,还需要转化成list类型。这些方面是初学者不易理解的地方,尤应注意。
3.如果以CLIENT列为分组依据(即非固定分组),则只需一句代码就能实现:
result<-aggregate(sales$AMOUNT,list(sales$CLIENT),sum)
总结:使用aggregate可以轻松实现本案例。
例2:分组依据超出数据集
分组依据仅限于列数据,这属于特殊情况,实际上由于分组依据来自于数据集之外(比如外部参数),它的成员很可能不在列数据中。本案例试图解决这样的问题。
假设“潜力客户列表”的值为[ARO,BON,CHO,ZTOZ],请将sales按照“潜力客户列表”将数据分为四组,并对各组的AMOUNT列汇总求和。注意,客户ZTOZ不在CLIENT列中。
与例1类似的代码:
byFac<-factor(sales$CLIENT,levels=c("ARO","BON","CHO","ZTOZ"))
result<-aggregate(sales$AMOUNT,list(byFac),sum)
上述代码的计算结果是:
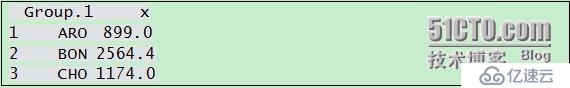
可以看到,计算结果中只有三组数据,缺失了ZTOZ,而不是要求中的四组。显然,上述代码不能实现本案例,需要改进。
改进后的代码:
byFac<-factor(sales$CLIENT,levels=c("ARO","BON","CHO","ZTOZ"))
tapply(sales$AMOUNT, list(byFac),function(x) sum(x))
计算结果:

代码解读:
1.改进后的代码更符合业务逻辑,四个分组都能呈现在结果中。
2.代码中使用了tapply进行分组汇总,这个函数的通用性比aggregate好,但tapply的名字不如aggregate直观,初学者大多搞不清楚。
3.ZTOZ的汇总值是NA,这说明ZTOZ不在CLIENT列中。如果ZTOZ的汇总值为0,则说明ZTOZ在CLIENT列中,但订单金额为0。
4.本案例中,分组汇总的结果只有四组,多余的客户不应该出现,这些客户可以称为“多余组”。计算多余组的汇总值不能在当前算法上简单改造,需要使用新的函数:
filtered<-sales[!is.element(sales$CLIENT,byFac),]
redundant<-sum(filtered$AMOUNT)
这段代码并不复杂,但实现思路和之前的代码明显不同。
总结:使用tapply可以轻松实现本案例。
例3:分组条件不重叠
以条件作为分组依据,这也是固定分组的一种,比如:将订单金额按照1000、2000、4000划分为四个区间,每个区间一组订单,统计各组订单的金额。
代码
byFac<-cut(sales$AMOUNT,breaks=c(0,1000,2000,4000,Inf))
result<-tapply(sales$AMOUNT, list(byFac),function(x) sum(x))
计算结果:

代码解读:函数cut将数据框划分为四个区间,函数tapply将数据框按照区间分组,并汇总出各组结果。
总结:cut和tapply配合可以轻松实现最简单的条件分组。
例4:分组条件有重叠,重复计算结果
在最简单的条件分组中,条件没有发生重叠,但实际上发生重叠的情况很常见,比如将订单金额按照如下规则分组:
1000至4000:常规订单r14
2000以下:非重点订单r2
3000以上:重点订单r3
这里的常规订单就会和另外两组发生重叠。发生重叠时就有是否要把重叠的数据重复计算的问题,本案例先解决重复计算的情况。
代码:
r14<-subset(sales,AMOUNT>=1000 & AMOUNT<=4000 )
r2<-subset(sales,AMOUNT<2000)
r3<-subset(sales,AMOUNT>3000 )
grouped<-list(r14=r14,r2=r2,r3=r3)
result<-lapply(grouped,FUN=function(x) sum(x$AMOUNT))
计算结果:

说明:r2和r3包含了r14的部分数据。
代码解读:
1.上述代码可以解决本案例,但已经显得很麻烦了,如果条件更多更复杂,上面的代码将会更长。
2.这里用到了一个新的函数lapply。迄今为止,为了实现固定分组,我们已经使用了很多函数,包括:factor、aggregate、list、tapply、cut、subset、lapply等等。而且同为条件分组,仅仅因为条件是否重叠,我们就需要用不同的函数和不同的思路去实现,掌握这些用法还是相当困难的。
3.上述代码的计算结果是list,前面几个案例有的是data.frame,有的则是array,这些不一致的地方在实际使用中也会造成麻烦。
总结:可以实现本案例,但代码较复杂,需要掌握很多函数。
例5:分组条件有重叠,结果不重复
之前的案例解决了数据重复时的问题,但有时我们需要不重复的计算结果,即:前面分组中出现过的数据不能出现在后面,针对本案例,具体的算法就是:r2不应该包含r14中的数据,r3不应当包含r2和r14中的数据。
代码:
r14<-subset(sales,AMOUNT>=1000 & AMOUNT<=4000 )
r2<-subset(sales,AMOUNT<2000 & !(AMOUNT>=1000 & AMOUNT<=4000))
r3<-subset(sales,AMOUNT>3000 & !((AMOUNT>=1000 & AMOUNT<=4000)) & !(AMOUNT<2000))
grouped<-list(r14=r14,r2=r2,r3=r3)
result<-lapply(grouped,FUN=function(x) sum(x$AMOUNT))
计算结果

注意:不重复计算数据时,r2和r3的值比之前计算出的结果小。
代码解读:为了实现不重复计算,上述代码加入了更多的逻辑判断,这就使代码复杂度进一步加大。可以想象,当分组数量较多,分组条件也比较复杂时,所要书写的代码量会相当大。
总结:可以实现本案例,但代码复杂稍显复杂。
第三方解决方案
上述例子也可以用Python、集算器、Perl等语言来实现。和R语言一样,这几种语言都可以实现固定分组汇总和结构化数据的计算,下面简单介绍集算器的解决方案。
例1:
byFac=["ARO","BON","CHO"]
grouped=sales.align@a(byFac, CLIENT)
grouped.new(byFac(#), ~.sum(AMOUNT))
计算结果:
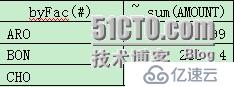
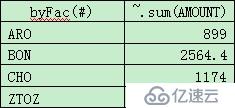
例2:
代码和例1完全一样,此处省略。
计算结果:
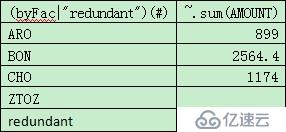
如果想统计多余组的汇总值,则代码只需稍作改动:
byFac=["ARO","BON","CHO","ZTOZ"]
grouped=sales.align@a@n(byFac,CLIENT)
grouped.new((byFac|"redundant")(#), ~.sum(AMOUNT))
红色部分即改动,其中@n表示在结果集中增加多余的一组,可以看到,这种写法要比R的代码易于掌握。
计算结果:
例3
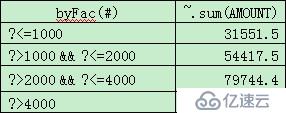
对于简单的条件分组,集算器只需将之前的align函数换为enum,其他地方不变。
byFac=["?<=1000" ,"?>1000 && ?<=2000","?>2000 && ?<=4000","?>4000"]
grouped=sales.enum(byFac,AMOUNT)
grouped.new(byFac(#),~.sum(AMOUNT))
计算结果:
集算器
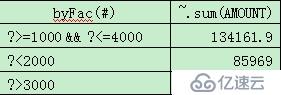
需要计算重复的数据时,只需要在之前的代码中加入@r选项。
byFac=["?>=1000 && ?<=4000","?<2000" ,"?>3000"]
grouped=sales.enum@r(byFac,AMOUNT)
grouped.new(byFac(#),~.sum(AMOUNT))
计算结果:
集算器
不需要计算重复的数据时,去掉@r选项即可,和简单条件分组完全一样。
byFac=["?>=1000 && ?<=4000","?<2000" ,"?>3000"]
grouped=sales.enum(byFac,AMOUNT)
grouped.new(byFac(#),~.sum(AMOUNT))
计算结果:
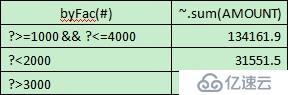
可以看到,集算器只需要align和enum这两个函数就可以实现所有类型的固定分组汇总,代码结构一致,解决思路简单。
下一篇:golang字符串常用方法